🎯 AlphaGo:AI 有了棋感
🕰️ 故事时间 · 那时候发生了什么?
2016 年 · 🎯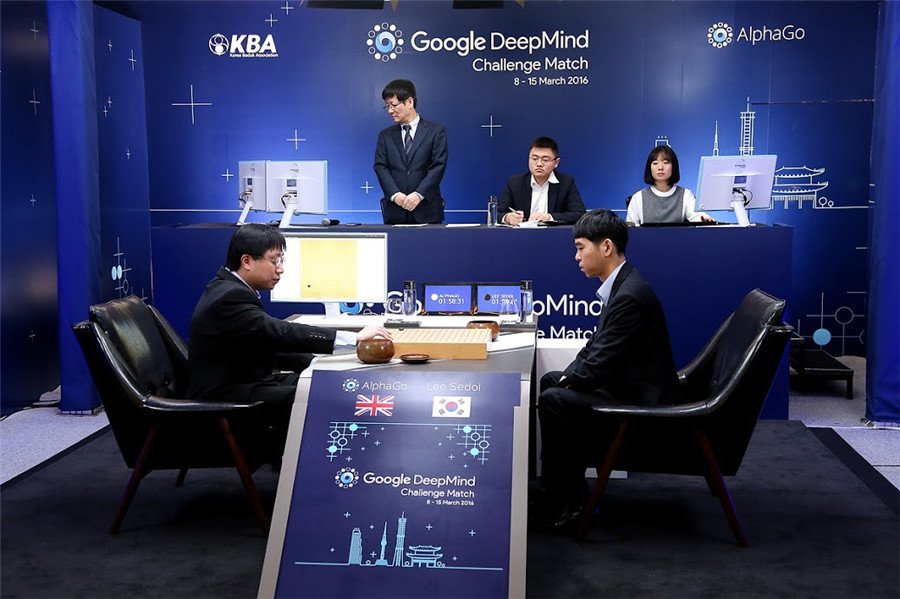
左边是李世石,右边替 AlphaGo 落子的是黄士杰
- 第一盘 3/9:AlphaGo 执白胜,李世石中盘认输
- 第二盘 3/10:AlphaGo 执黑胜 —— 赛后李世石承认它「下得近乎完美」(媒体报道多在第三盘之后)
- 第三盘 3/12:AlphaGo 执白胜,总比分变成 3 : 0
- 第四盘 3/13:李世石执白胜 —— 第 78 手「神之一手」,人类赢下的唯一一盘
- 第五盘 3/15:AlphaGo 执白胜,总比分定格 4 : 1
🖼️ 图片:2016 年首尔挑战赛现场(来源 mensgear.net,网络公开图片,仅作教学使用)
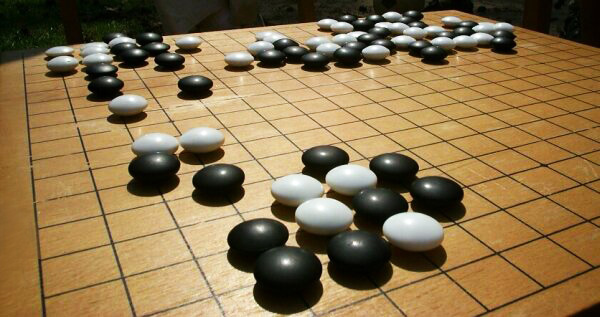
围棋看着简单——黑白两色的石头,轮流往交叉点上放。可它是棋类里最难的:棋盘上的变化比宇宙里的原子还多,每走一步大约有 250 种选择。
1997 年「深蓝」靠把每步能想到的走法往前算很多步、再挑最好的一步赢了国际象棋,可这一招在围棋上完全行不通——根本算不完。所以赛前,几乎没有人觉得电脑能赢。
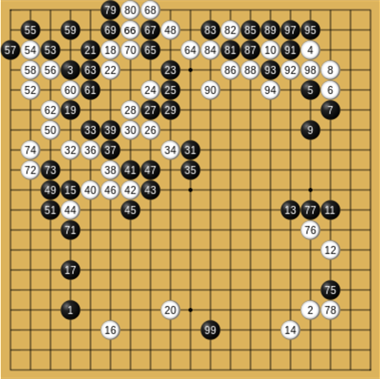
2015 年 10 月,英国 DeepMind 公司的程序 AlphaGo 悄悄和欧洲冠军樊麾下了五盘——5:0 全胜。这是历史上第一次有程序在公平对局中战胜围棋职业棋手。
2016 年 1 月,这件事登上了《自然》(Nature)杂志封面。全世界这才知道:围棋,也被攻下了。
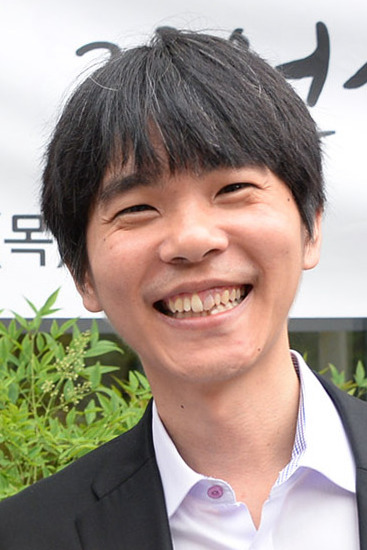
2016 年 3 月,首尔:世界冠军李世石端坐在棋盘前,对面没有真人对手,只有一个叫 AlphaGo 的程序。这场「人机大战」下五盘,全世界几亿人屏住呼吸观看。
结果 AlphaGo 一连赢下三盘,比分一度是 3:0。
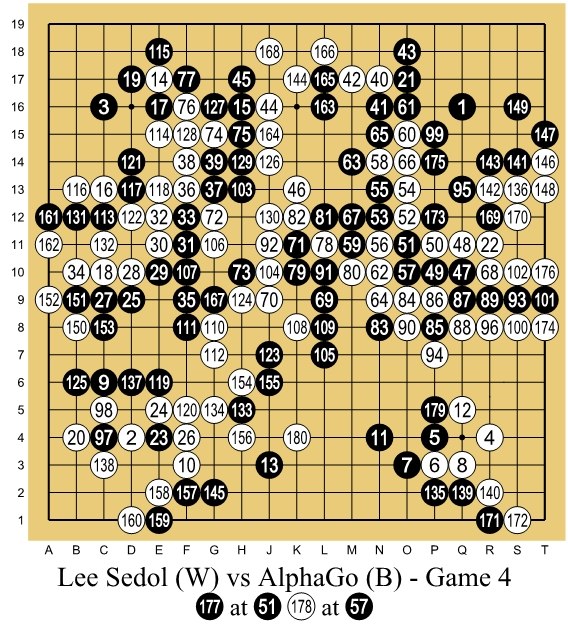
第四盘,李世石下出第 78 手——一步看起来「毫无道理」的棋,解说员一开始都以为他下错了。可就是这一步,让 AlphaGo 彻底乱了阵脚,它连出昏招,最后投子认输。
人们把这一步称为「神之一手」。最终五盘比分定格在 4:1,AlphaGo 获胜,但李世石赢下了人类尊严的一局。
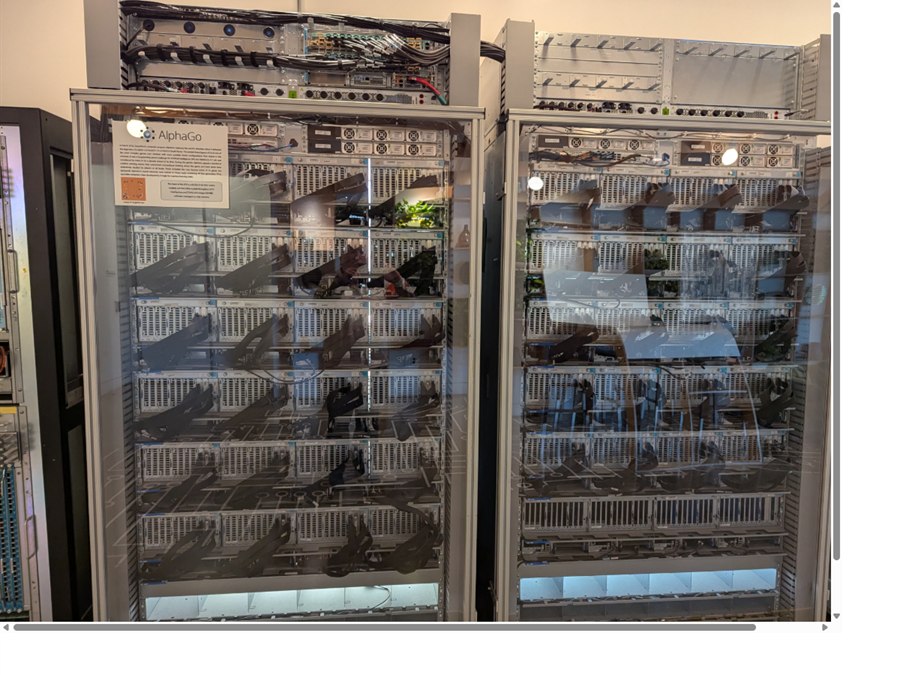
AlphaGo 靠的不是算得更多,而是学会了「棋感」:它先向人类高手的棋谱学习,再自己跟自己下几百万盘,在无数次输赢里总结经验,练出了像人一样的直觉。
这种「自己和自己对弈、在试错中变强」的方法,就叫强化学习。后来它连人类棋谱都不看了(AlphaGo Zero),照样天下无敌。
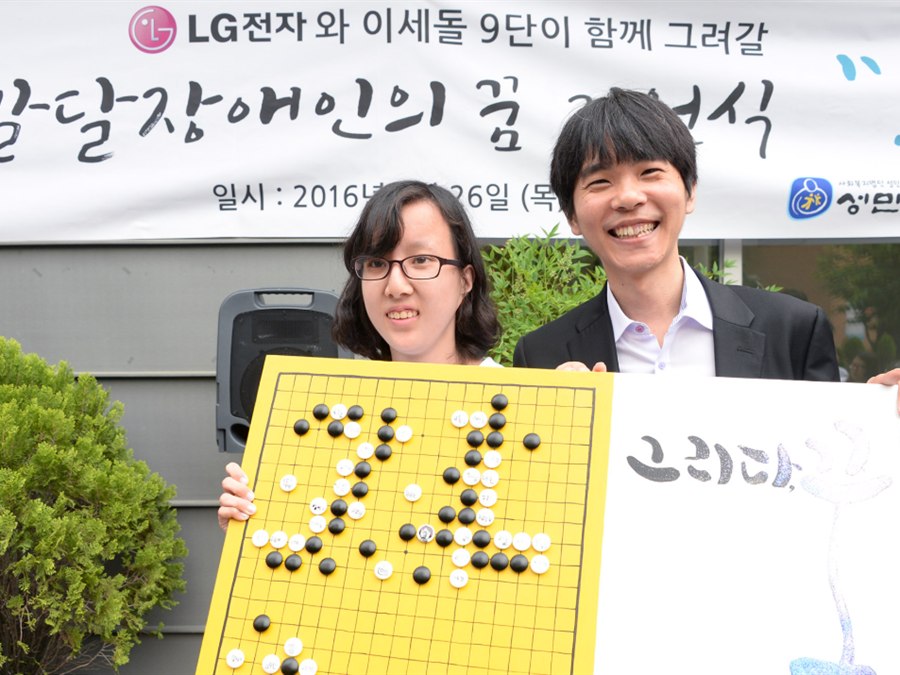
李世石输了比赛,却让全世界看清了两件事:机器的棋力已经站上人类顶峰,而他那步绝妙的反击也提醒我们——人的创造力与勇气,依然闪闪发光。
从这以后,AI 走进了日常:手机下棋、认人脸、翻译、开车……今天你身边的许多 AI,都用着和 AlphaGo 同一套「自己学」的本事。
🖼️ 图片:围棋棋盘、AlphaGo 计算机机柜、樊麾与李世石对局棋谱、李世石照片等取自维基共享资源(Wikimedia Commons);比赛现场照片来源 mensgear.net,仅作教学使用