📐 Transformer:注意力改变了世界
🕰️ 故事时间 · 那时候发生了什么?
2017 年 · 📐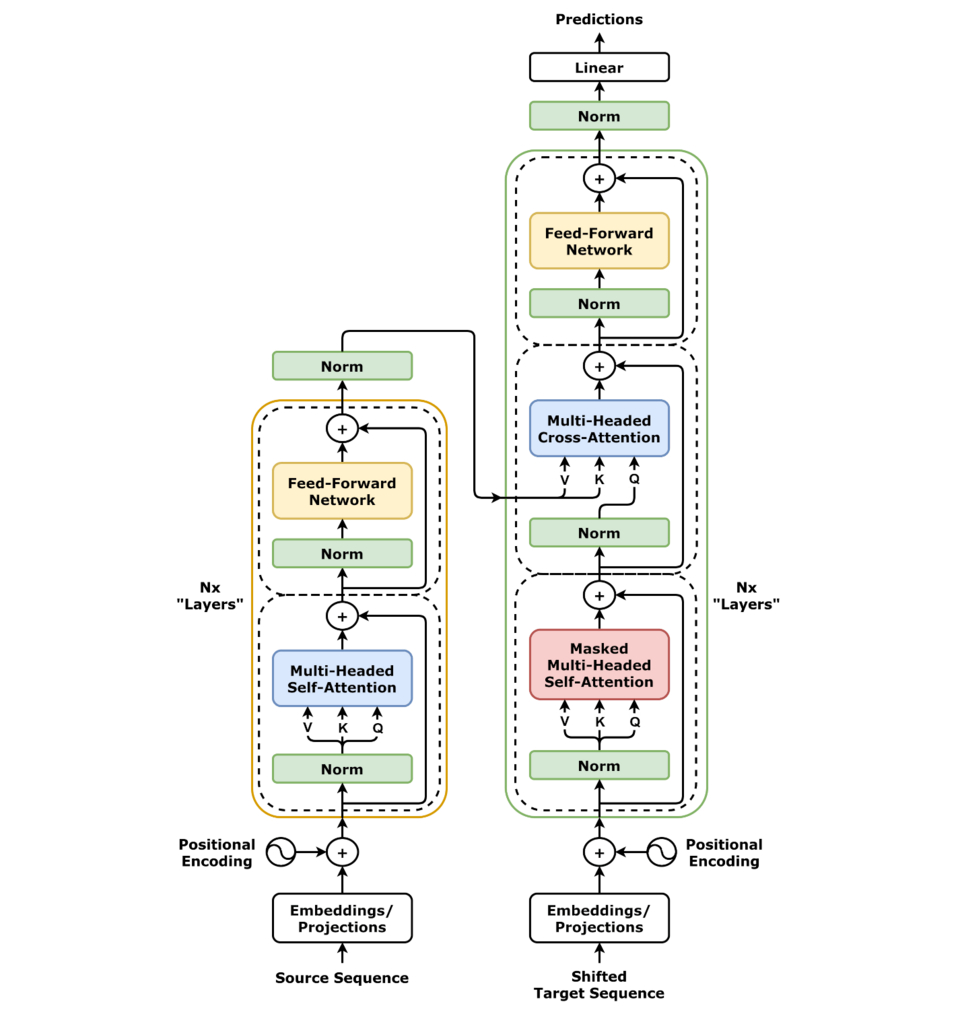
🖼️ 结构图:Transformer 全架构图 · CC BY 4.0 · Wikimedia Commons
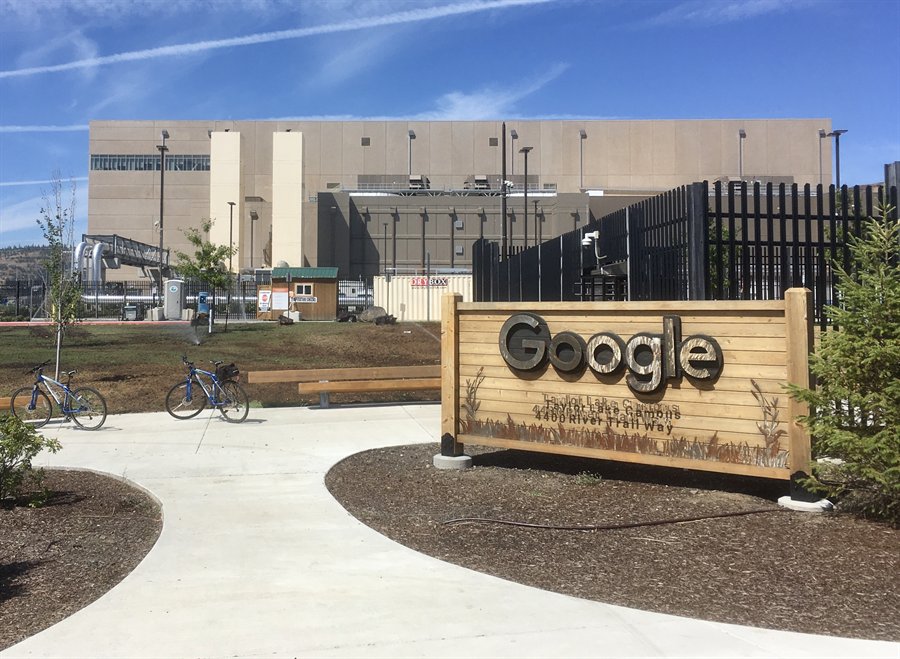
那是机器翻译已经很常见的年代:谷歌翻译每天要翻译上千亿个词。可它读句子的老办法有个大毛病——像排队一样,一个字一个字顺着读。
句子一长就出问题:读到后面,「排队」在前的词早就忘得差不多了;而且只能一个词一个词往下走,慢。翻译长句子时,机器常常「记不住、翻不准」。
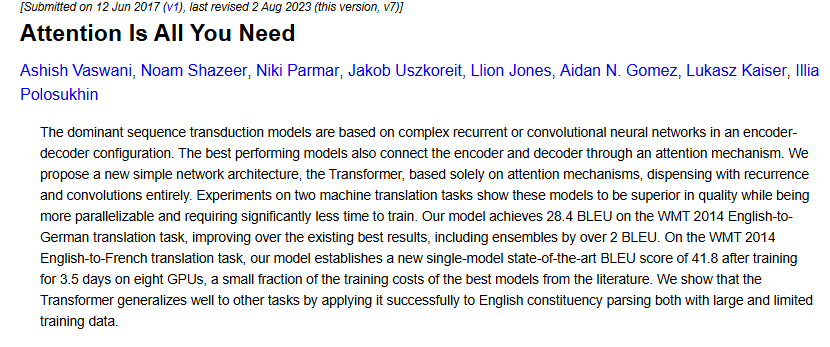
2017 年 6 月 12 日,一篇论文被上传到 arXiv,标题很霸气:《Attention Is All You Need》——「注意力,就是你所需要的一切」。
作者是谷歌的八位研究员。他们提出了一种全新的结构 Transformer:里面没有排队、没有循环,只留下一个机关——「注意力机制」。
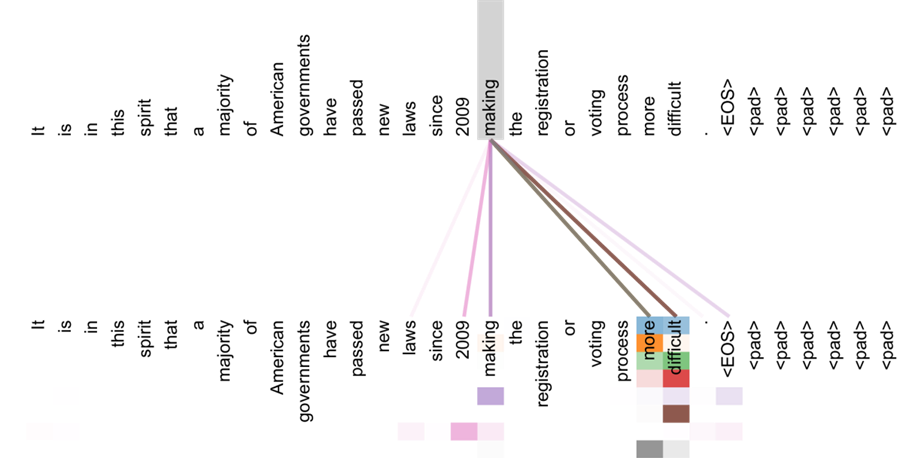
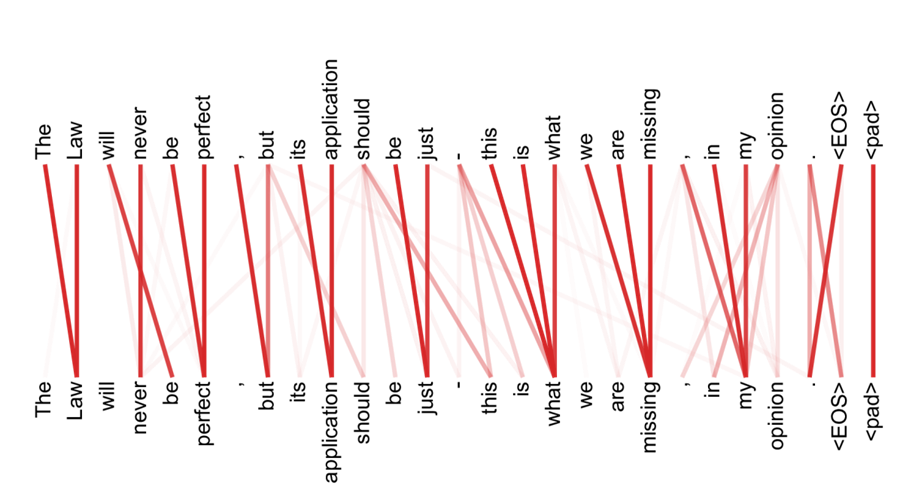
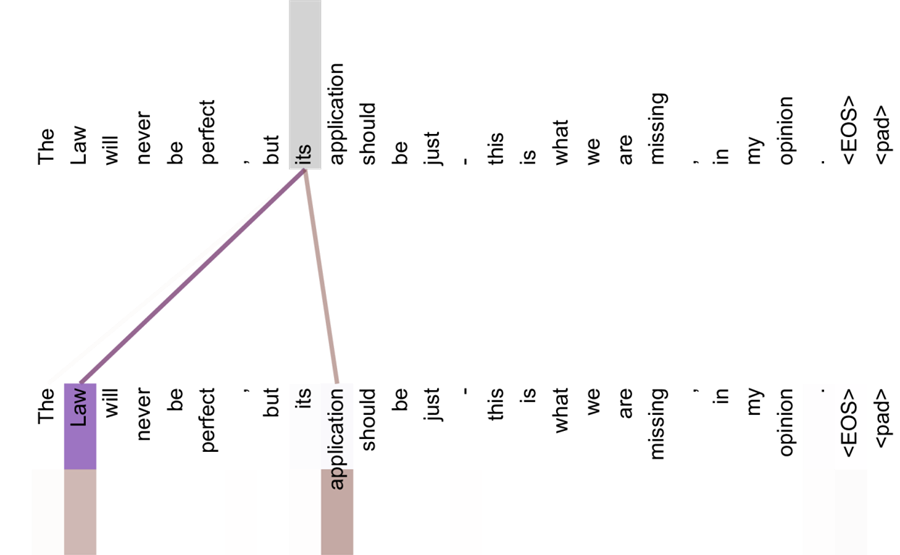
注意力做的事,就是让每个词自己去看该看谁。翻译这句话时,「making」一眼就望见了很远的「more」和「difficult」——隔得再远也忘不了。
它还能分清「它」指的是谁:句子里的 its 死死盯着前面的 Law。机器第一次学会了「指代」这件事。下面三张都是论文里的原图,点开可以放大看连线。
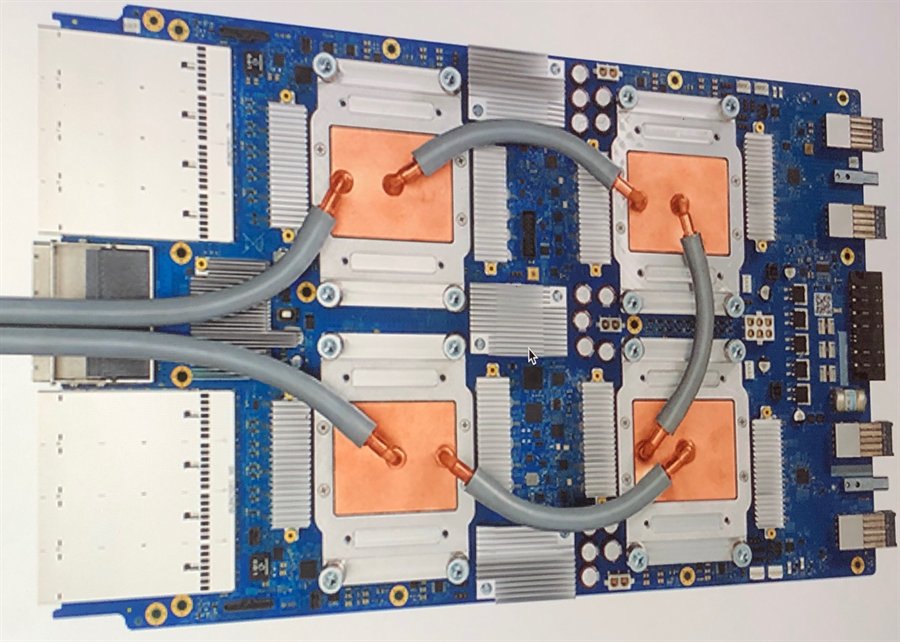
论文在 2017 年 12 月的 NeurIPS 大会上正式发表,代码和模型全部公开。有意思的是,论文里写着:当时最好的模型只用 8 块 GPU 训练 3.5 天——在那会儿,算是又快又省。
从那以后大家都改用它:2018 年起 BERT、GPT 一个接一个冒出来,模型越做越大,也越来越「聪明」。
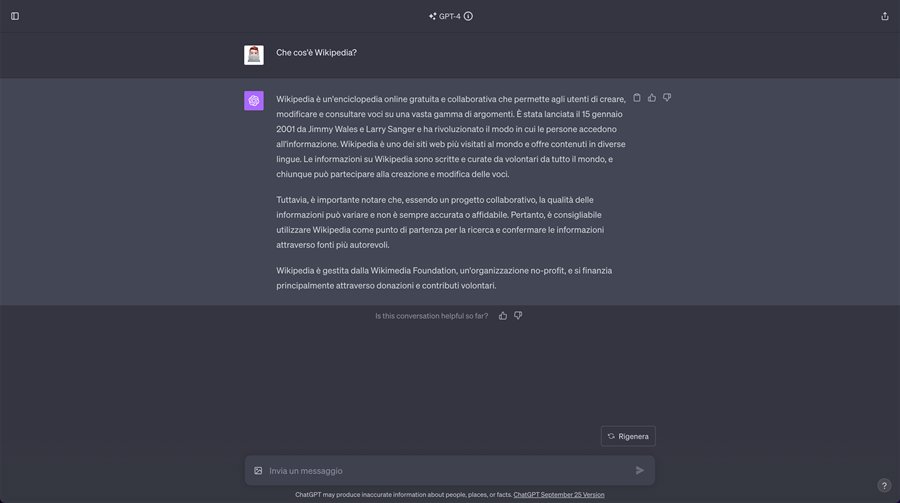
今天你听过的大语言模型——ChatGPT、Gemini、文心一言、通义千问——几乎都是这篇论文的「后代」。它们读句子用的还是同一招:注意力。
八位作者大概也没想到:自己写下的几张纸,成了整个 AI 时代的地基。
🖼️ 图片:机房照片、TPU 实物照来自维基共享资源(Wikimedia Commons,CC BY-SA 4.0);论文页面、注意力可视化、ChatGPT 界面为真实论文原图与页面截图,仅作教学使用