← 返回课程 🛰️ E04 · 第12课 2018 年 · 人工智能简史 📚 自然语言处理(NLP)自然语言处理(NLP)让机器理解和生成人类语言:翻译、搜索、客服、写作都靠它。层级:人工智能 ⊃ 自然语言处理(里面用的是机器学习・深度学习)本站在这一门里的位置:2018 年 BERT 会「双向读上下文」,把 NLP 推到新高度。

📚 BERT:会读诗、懂情感的语言小天才

🎯 认识 2018 年 Google 提出的 BERT——用双向编码器同时“读懂”前后文,刷新 11 项 NLP 任务纪录
2018 📚 第 12 站 / 16 · 2018 年

BERT:会读诗、懂情感的语言小天才

Google 提出双向编码器表示,刷新 11 项 NLP 任务纪录
🎯 本课目标:认识 2018 年 Google 提出的 BERT——用双向编码器同时“读懂”前后文,刷新 11 项 NLP 任务纪录

🕰️ 故事时间 · 那时候发生了什么?

2018 年 · 📚
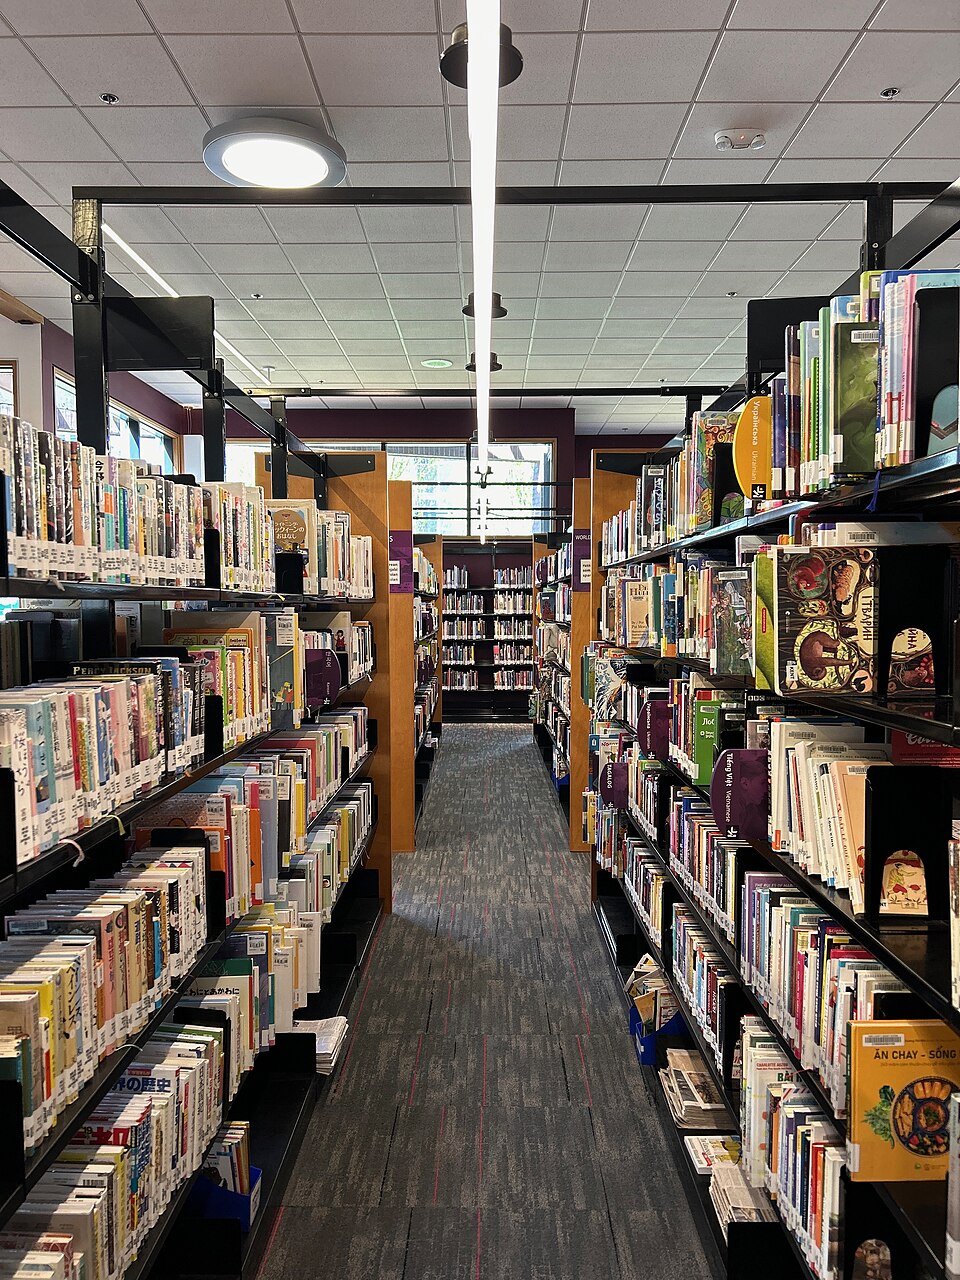
摆满世界各地书籍的图书馆
BERT 的「课本」:数不清的书与网页——它用几十亿道「完形填空」练出了对语言的理解

🖼️ 图片:图书馆实拍 · Wikimedia Commons(CC0)

什么是 NLP
一个智能音箱的照片
对它说一句话,它得先「听懂」——这就是 NLP 在干活。背景 · 真实照片

让机器听懂人说的话、读懂人写的字,这件事叫 NLP(自然语言处理):AI 里最有用、也最难的方向之一。难就难在人话太多变——「苹果」可能是水果,也可能是手机;「它的毛很软」里的「它」是谁,还得看前面的句子才知道。
1950 年代
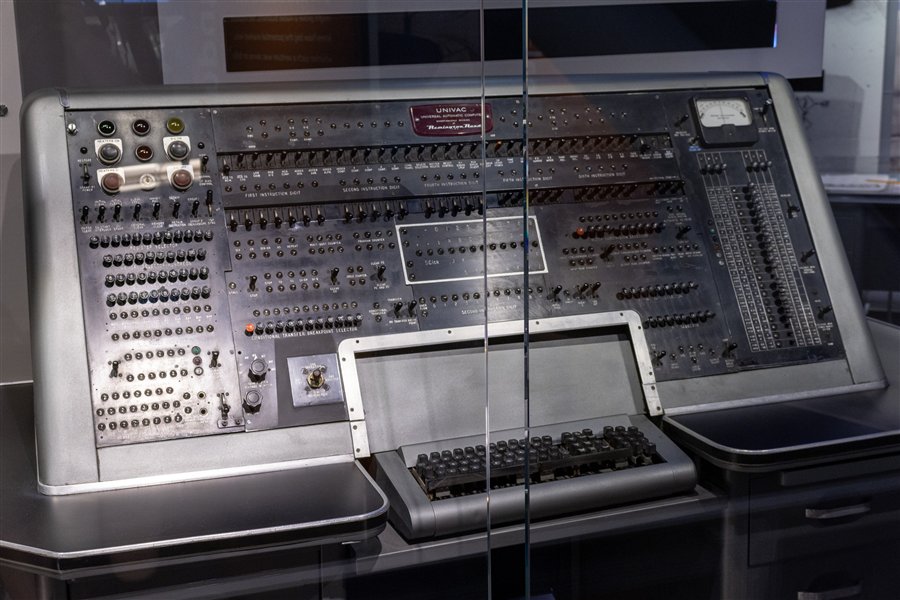
1951 年的 UNIVAC 电脑控制台,一排排旋钮和开关
1951 年的 UNIVAC 电脑控制台:那会儿的电脑都有一间屋子那么大(1954 年做翻译实验的那台是 IBM 701,也是这种大家伙)。背景 · 真实照片 · Computer History Museum

人类最早想让机器处理语言,就是在这种「一间屋子那么大」的电脑上试的。1954 年,一台 IBM 701 当众把 60 句俄语翻成了英语——规则全靠人一条条写进去,多一句就不灵了。
2018 年之前
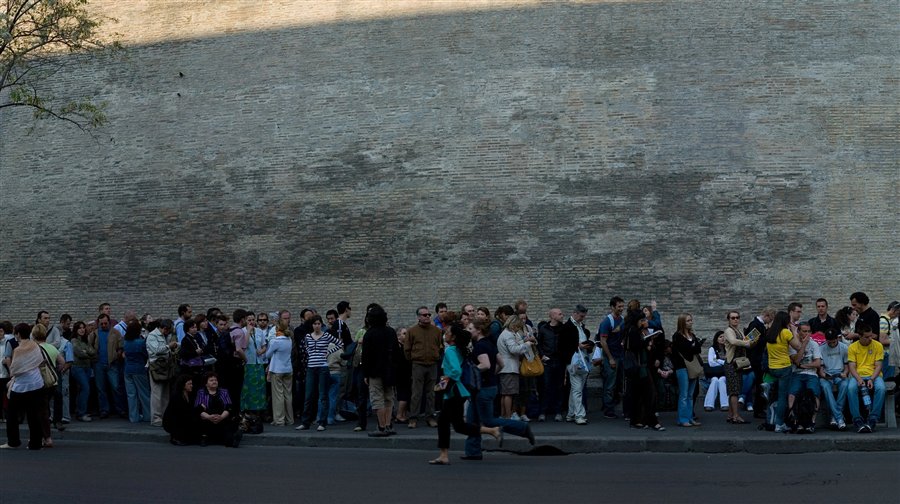
一队排得长长的等待入场的人群
读一个词,才轮到下一个词——老办法像一条排得长长的队伍。背景 · 真实照片

后来机器聪明多了,可读句子还是「排队」:一个字一个字顺着读,读到后面就忘了前面;有的干脆两个方向各读一遍,再把结果拼起来。句子一长它就开始糊涂,「它」指的是谁也分不清。
2018 年 10 月 11 日 · 提出
一个孩子捧着一本书在读
我们读书时会前后一起看——BERT 学的就是这一招。提出 · 真实照片

2018 年 10 月 11 日,Google 的四位科学家提出 BERT:读到一个词时,左边和右边一起看。就像我们读「小明把蛋糕藏进了冰箱」——读到「藏」的那一下,自然会想起前面的「小明」和后面的「冰箱」。
2018 年 10 月 · 怎么练出来
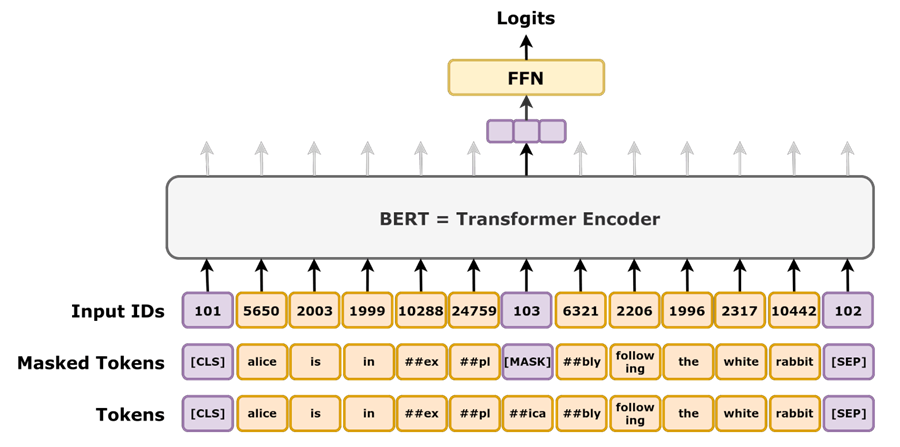
完形填空训练的示意图:把词换成 MASK,让模型猜回来
它的题目长这样:挖掉一个词、换成 [MASK](占位符:表示「这里被挖掉了」),让它猜回来。图解 · Daniel Voigt Godoy(CC BY 4.0)

练法很像语文考试的完形填空:把句子里的词挖掉,让它靠前后文猜回来——「我 ▢ 吃苹果」,猜出「爱」;再加一道「这两句话接得上吗」。几十亿道题做下来,它就摸到了语言的规律。
2018 年 10 月底 · 发布
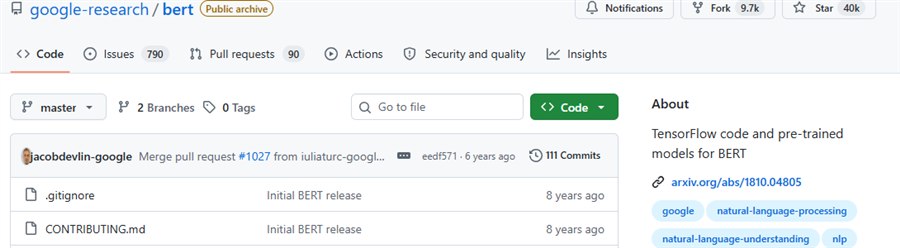
GitHub 上 google-research/bert 仓库的截图:代码、模型与星标数
Google 把代码和模型全部公开,放在 GitHub 上(如今三万多颗星标)。发布 · 真实仓库截图

2018 年 10 月底,Google 把 BERT 的代码和模型全部公开,还放出中文版——谁都能下载来用。它一口气在 11 项语言理解比赛里拿下第一,有的题目(比如阅读理解)甚至比人答得还好

✨ 影响
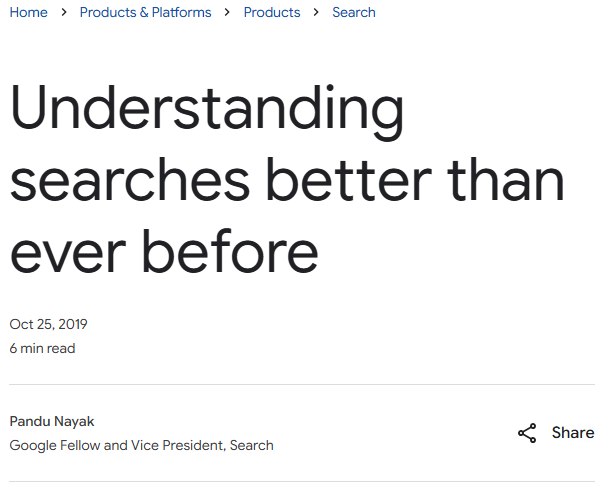
Google 官方博客公告截图:Understanding searches better than ever before
2019 年 10 月 25 日,Google 官方公告:搜索用上了 BERT。影响 · Google 官方博客截图

2019 年,Google 搜索用上了 BERT:你随口问的一句话,哪怕说得颠三倒四它也能懂。今天手机的输入法、翻译、客服、智能音箱背后都有它的影子——它还留下「先海量地读、再针对具体活儿练一练」这套做法,后来几乎所有大模型都照着走。NLP 从此从「机器能读」走向了「机器能懂」。

🖼️ 图片:智能音箱、1951 年 UNIVAC 电脑、排队的队伍、读书的孩子、图书馆均为真实照片(Wikimedia Commons / Computer History Museum,CC BY 2.0 / CC BY-SA 4.0 / CC BY 4.0 / CC BY-SA 3.0 / CC0);完形填空图解来自 Daniel Voigt Godoy(CC BY 4.0);GitHub 仓库与 Google 博客为真实页面截图,均仅作教学使用

📖 知识小课堂 · 记住这个魔法!

点击卡片翻开,看看背后的知识~

双向读取👆 点我翻开
读一个词时同时看左边和右边 → 理解更深
💡完形填空训练👆 点我翻开
把句子挖掉词,根据前后文把空填上 → 越填越懂语言
🧩NLP 是什么👆 点我翻开
让机器听懂人说的话、读懂人写的字,是 AI 里最有用也最难的方向之一
🕰最早的一次尝试👆 点我翻开
1954 年,一台 IBM 701 当众把 60 句俄语翻成英语,规则全靠人写
🔑11 项纪录👆 点我翻开
2018 年 BERT 刷新 11 项 NLP 任务纪录,轰动全世界
📚它的课本👆 点我翻开
几十亿道「完形填空」练下来,它就摸到了语言的规律
🌐代码全部公开👆 点我翻开
2018 年 10 月底,Google 把代码和模型全部公开,还放出中文版
🔎后来用在搜索上👆 点我翻开
2019 年 Google 搜索用上了 BERT,随口问的一句话它也能懂

🖐️ 动手试一试 · BERT 唐诗情感分类

🌸BERT 唐诗情感分类实验室先由规则给每句诗标好情感,再让 BERT 学会自己判断「情感立意」

🎯 实际问题

  • BERT(一个专门「读懂」语言的模型)读过一句诗后,能判断出它写的「情感立意」:是立大志、想家、写给朋友,还是想念心上人……
  • 我们造一个迷你 BERT:先读熟一批由规则预标好情感标签的唐诗句子(数据取自 zeroai 的 tanshi.txt),学会字与字之间的规律,然后你给它一句诗,它就能判断属于哪一类情感。
  • 它的秘密是双向自注意力——读每个字时,把整句(左边 + 右边)都看一遍,最前面的「[CLS] 帽子」再收成整句向量去分类。这正是 BERT 和只会「从前向后读」的 GPT 最大的不同。

📋 训练数据格式

输入(一句整诗 + 情感标签):「下马饮君酒,问君何所之。」→ 🤝 友情·送别
输出(8 类情感之一):🚀 言志·抱负 / 🏠 思乡·羁旅 / 🤝 友情·送别 / 💕 爱情·相思 / 🌿 山水·隐逸 / ⚔️ 边塞·豪情 / ⏳ 叹老·伤时 / 🏛️ 咏史·怀古
核心任务:读熟 3000 句带标签的诗(取自 tanshi.txt,由关键词规则自动打标),再给一句新诗,猜它属于哪一类
例子①:「从此思乡泪,双垂不复收。」→ 🏠 思乡·羁旅
例子②:「青春须早为,岂能长少年。」→ 🚀 言志·抱负
例子③:「明月松间照,清泉石上流。」→ 🌿 山水·隐逸

诗句来自 zeroai / AI200 的 tanshi.txt,每句的情感标签由「大模型」预先标好。字先变成字向量,经过双向自注意力,最前面那顶「[CLS] 帽子」把整句收成一个向量,最后对 8 类情感打分。训练完还会用 500 句没读过的诗考一考它。

🧠 BERT 可视化训练器 整句 12 字 · 8 维向量 · 2 头双向注意力 · 8 类情感

先点「🎬 开始可视化训练」,看它一遍遍读带标签的诗句,学会把「整句的意思」和 8 类情感对上(损失下降 + 注意力点亮);再用「👣 单步」一步步看它对一句诗怎么判断。

📚 训练数据集(带情感标签) 3000 句 · 8 类
🧪 测试数据集(考卷) 500 句 · 点击考考它

这 500 句是考卷——训练时 BERT 从没见过。点一句,让 BERT 现场判断;行尾的 ❓ 鼠标移上去会露出「正确答案」。

🧠 BERT 网络 · 7 步:输入整句 → 字向量 → 位置向量 → 双向自注意力 → [CLS] 整句向量 → 情感打分 → Softmax(把分数变成百分比)
📉 损失曲线(越低越好 · 实线:蓝=训练 红=测试
🎯 准确率曲线(越高越好 · 虚线:绿=训练 橙=测试
学习率 η =
状态: 就绪 📉 损失: 🔢 步数: 0 📚 epoch: 0
📊 数据面板 当前样本

🔍 互动演示:让 BERT 判一句诗的情感

先点上方「🎬 开始可视化训练」让 BERT 读熟这些标好情感的诗句;再在框里输入一句诗(或点「🎲 换一句」),点「🧠 判情感」——下方会列出它对 8 类情感的把握,右边会亮出它「双向看完整句」时帽子❂ 和每个字的关注度(越红越关注)。

(先训练,再点「🧠 判情感」!)
🔍 双向注意力 · 帽子看全句 + 字字互看

❓ 小测验 · 你学会了吗?

点选答案,答对会变绿、答错会变红(可重试)~

Q1. BERT 的「双向」是什么意思?

Q2. BERT 主要是靠什么方式训练的?

Q3. 2018 年 BERT 最轰动的成绩是什么?

Q4. 在唐诗实验室里,BERT 要判断的是诗句的什么?

Q5. 那个实验室一共分几类情感?

Q6. 训练用的那 3000 句唐诗,标签是谁给的?

Q7. 那 500 句「考卷」是干什么用的?

Q8. BERT 靠哪一个符号把整句收成一个向量去分类?

🏁 回顾与完课 · 为自己盖章

我从故事里记住了一个新知识我能把这个故事讲给家人听我完成了一次小任务挑战我想把这一站和下一站连起来想一想

💭 思考一下:读书时「只看前面」和「前后都看」,理解的差别有多大?造一个需要回头看的句子,考考爸爸妈妈吧。

🏅

人工智能简史 · 完课证明

小小学员 完成了 本站BERT:会读诗、懂情感的语言小天才

学会:Google 提出双向编码器表示,刷新 11 项 NLP 任务纪录

第 12 站
已完课