← 返回课程 🛰️ E04 · 第14课 2021 — 2023 年 · 人工智能简史 🎨 多模态 AI(看 / 听 / 画)多模态 AI(Multimodal)模态就是信息的种类(文字、图像、声音、视频)。多模态 AI 能同时看、听、写、画,把它们放进同一个模型里。层级:人工智能 ⊃ 机器学习 ⊃ 深度学习 ⊃ 多模态 / 生成式 AI本站在这一门里的位置:2021—2023 年 CLIP、DALL·E、GPT-4 把「看懂图」和「画出来」合到了同一个模型里。

🎨 多模态 AI:看得见、听得懂、画得出

🎯 认识多模态 AI:不只读文字,还能看图、听声、绘画,像人一样用多种感官理解世界
2023 🎨 第 14 站 / 16 · 2023 年

多模态 AI:看得见、听得懂、画得出

AI 长出了「眼睛、耳朵和画笔」
🎯 本课目标:认识多模态 AI:不只读文字,还能看图、听声、绘画,像人一样用多种感官理解世界

🕰️ 故事时间 · 那时候发生了什么?

2023 年 · 🎨
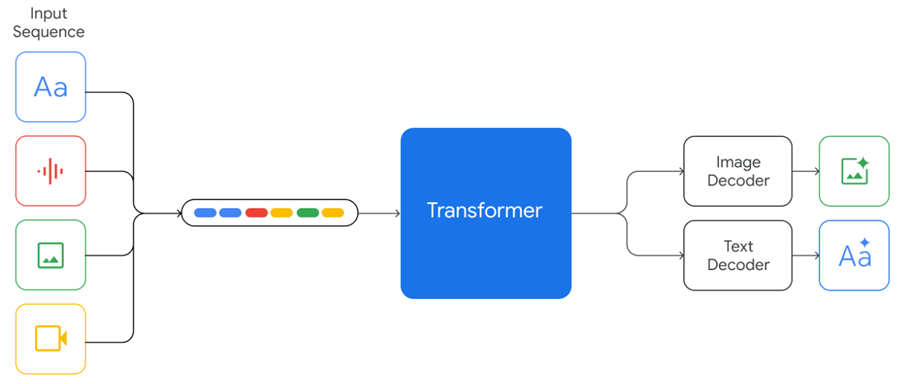
多模态示意图:文字、图片、声音、视频一起输入同一个模型
「多模态」就是:文字、图片、声音、视频一起进来,它一起理解

🖼️ 图片:多模态输入示意图 · CC BY 4.0 · Wikimedia Commons
2017 — 2020 年
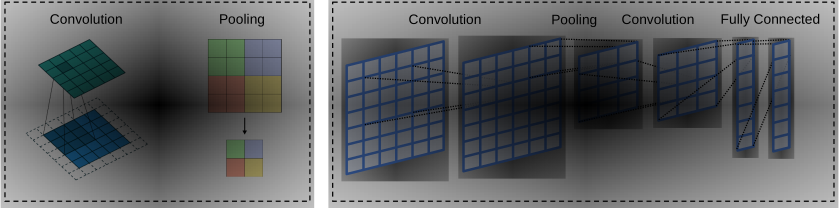
卷积与池化的示意图:图像一圈圈被提取特征
「看图」和「读字」本来是两套技术,各干各的。背景 · 只会一件事

那时候的 AI 是单科生:会看图的一直在认图——一圈圈做「卷积、池化」,把图像变成特征;会读字的一直在读字。两边语言不通,谁也说不清对方看到了什么。
2021 年 1 月 · 把图和字对上
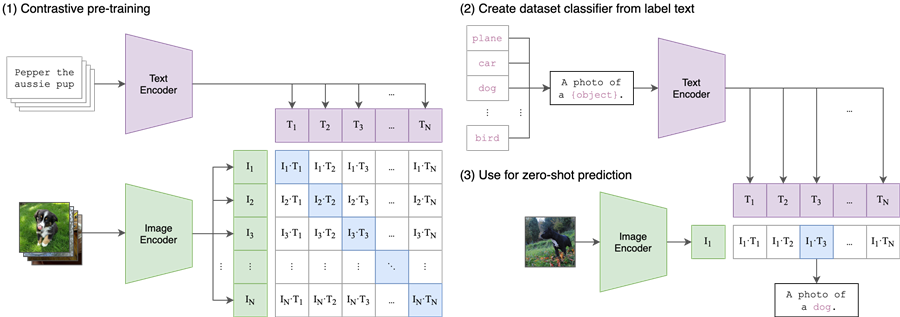
CLIP 示意图:图片与文字被编码到同一个空间里比较
4 亿组「图片 + 一句说明」,让它把图和字放进同一个空间。提出 · 图文配对(CLIP)

OpenAI 的 CLIP 想了个办法:拿 4 亿组「图片 + 说明」一起练。练完以后,图和字被放进同一张「地图」——意思相近的就靠在一起,它第一次把「看到的」和「说出的」对上了。
2021 年 1 月 · 一句话画一幅画
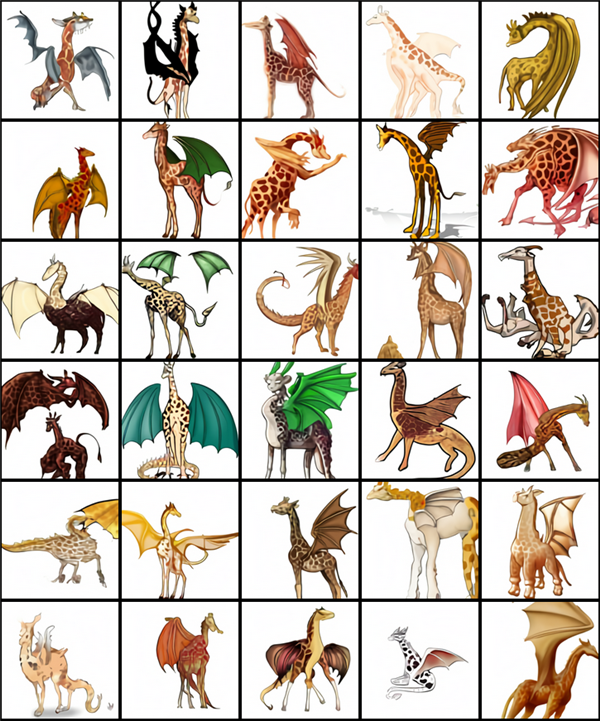
DALL·E 根据文字描述生成的几张图像
说一句话,它给你一幅新图——这叫「文生图」。提出 · 文生图(DALL·E)

有了这本事,「文生图」就顺理成章了:你描述「一只戴宇航员头盔的橘猫,在月球上吃冰淇淋」,它就把这句话变成一幅画——这幅画以前从没在世界上出现过。
2022 年 7 — 8 月 · 发布:人人可用
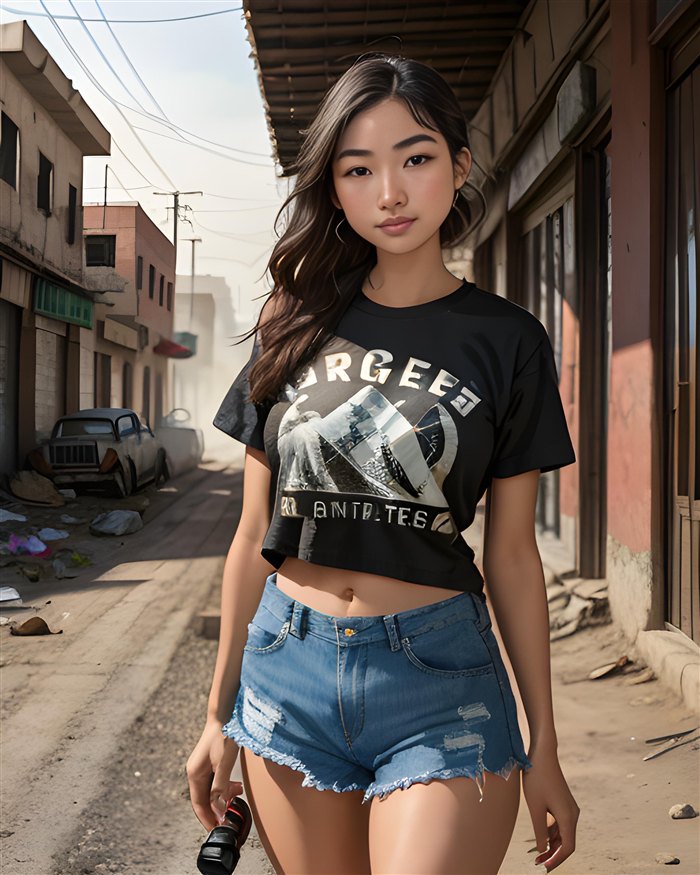
由 Stable Diffusion 生成的图片
开源之后,普通人也能自己「画」出这样的图。发布 · 走向大众

2022 年夏天,画图工具开始「出圈」:Midjourney 开放使用,Stable Diffusion 干脆把模型开源——下载到自己电脑上就能跑。会打字的人,都能当「画师」。
2022 年 9 月 · 长出耳朵
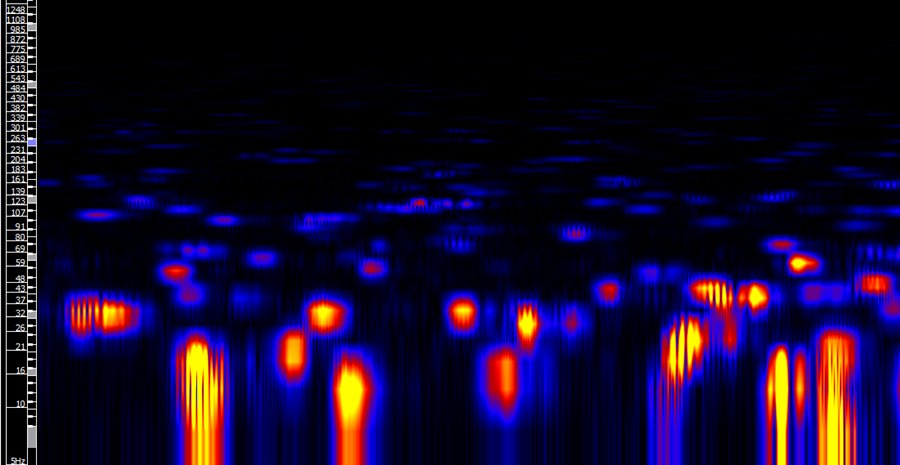
一段声音的频谱图
声音变成这样的「频谱图」,AI 就能把它听成文字。新能力 · 听懂人话(Whisper)

同年 9 月,OpenAI 开源了 Whisper:先把声音切成一小段一小段(变成频谱图),再转成文字。开会录音、外语视频、课堂笔记,它都能自动听写成文字。
2023 年 · 长大一圈:多模态
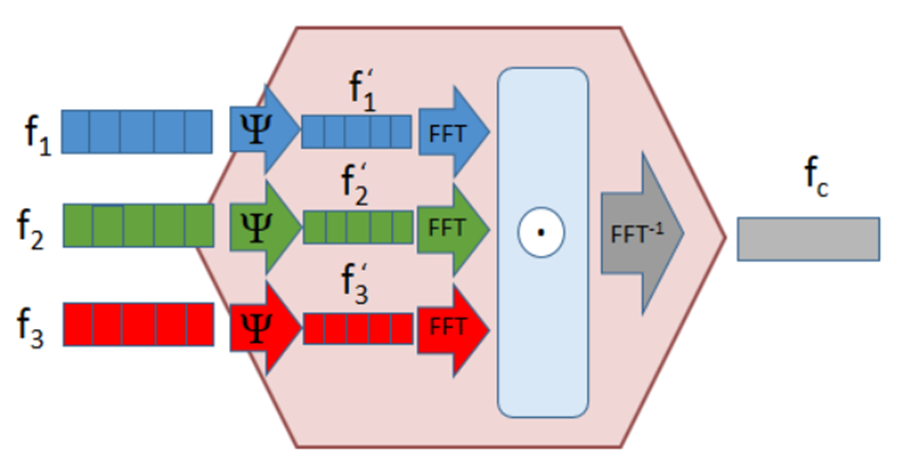
多模态融合示意图:几路不同来源的信息合成一个结果
图、文、声几路信息,最终合成一个整体理解。多模态 · 多种信息一起处理

2023 年,AI 不再只会读一种东西:文字、图片、声音、视频可以一起进来。拍一张照片问它「这是什么花」,它认得出;给它一段音乐,它能说出是欢快还是忧伤。它第一次像人一样「多感官」地理解世界。
2024 年 2 月 · 让画面动起来
由文生视频模型生成的一段画面
这段画面不是拍出来的,是「说」出来的。新能力 · 文生视频(Sora)

2024 年 2 月,AI 又跨了一步:给一句话,它能生成一段会动的视频(这就是「文生视频」,下一站细讲)。到这一步,它不只看得见、听得见,还能把画面「造」出来——风吹过、人走动、镜头推进,都能按你说的来。
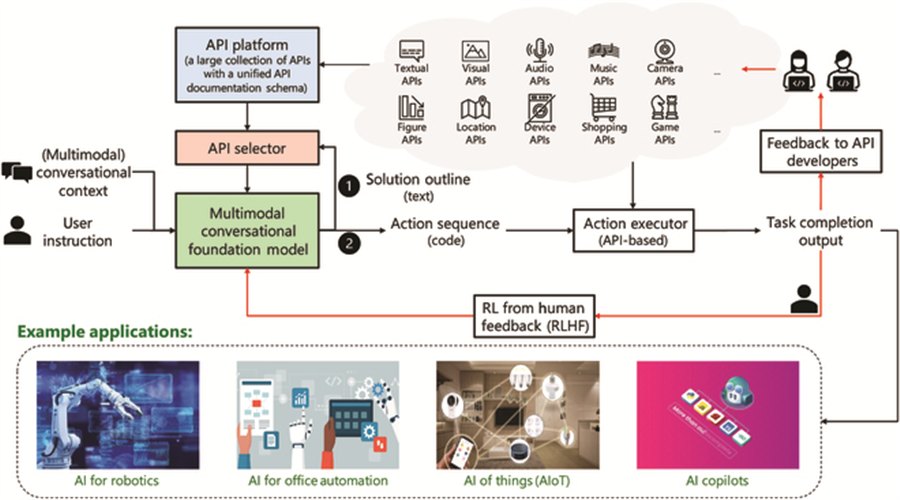
✨ 影响
示意图:一个基础模型接上许多工具,可以完成各种任务
一个「大脑」,配上一大堆工具,什么活都能接。影响 · 走进各个领域

今天,多模态 AI 已经走进很多行业:帮医生看片子、帮设计师出草图、帮农民认病虫害、帮我们翻译图片上的外文。你脑海里的奇思妙想,说一句话就能变成看得见的画面——这就是它带来的最大变化。

🖼️ 图片:卷积池化示意图(CC BY 4.0)、CLIP 图文配对图(MIT)、DALL·E 生成样本(公有领域)、Stable Diffusion 生成图(公有领域)、声音频谱图(CC BY-SA 4.0)、多模态融合示意图(CC BY 3.0)、文生视频画面(CC BY-SA 3.0)、基础模型+工具示意图(CC BY 4.0)——均为真实技术图纸 / AI 生成图 / 界面截图,仅作教学使用

📖 知识小课堂 · 记住这个魔法!

点击卡片翻开,看看背后的知识~

多模态👆 点我翻开
不只文字:能看图、听声、绘画,多种信息一起处理
💡文生图👆 点我翻开
用一段话描述,AI 就能生成对应的画面
🔑像人一样👆 点我翻开
用眼睛看、用耳朵听、用笔画——AI 越来越像我们
🧍以前的单科生👆 点我翻开
会看图的一直在认图,会读字的一直在读字,两边语言不通
🖼️图和字对上号👆 点我翻开
2021 年 CLIP 用 4 亿组「图片 + 说明」一起练,把图和字放进同一张地图
🎨一句话画一幅画👆 点我翻开
DALL·E:说一句「戴宇航员头盔的橘猫在月球上吃冰淇淋」,它就画出来
🎤长出耳朵👆 点我翻开
2022 年 9 月开源的 Whisper:把声音变成频谱图,再转成文字
🎬让画面动起来👆 点我翻开
2024 年 2 月,给一句话就能生成一段会动的视频

🖐️ 动手试一试 · 迷你 CLIP:用一句话搜图

2021 年 OpenAI 的 CLIP 是 AI 学会「看图又懂字」的关键一步:它用 文字编码器 + 图片编码器,把文字和图片都变成同一个向量空间里的向量,再算「搭不搭」。下面的图库是 真的 MNIST 手写数字(0–9,共 120 张,CLIP 看不到「这是几」的标签)——你说一句话,它凭「长得像不像」帮你把最像的图找出来!

🗣️ 你想找什么样的图?
📚 图库:120 张 MNIST 手写数字 🤫 在 CLIP 眼里,它们都是「没名字的图」

真 · MNIST 测试集(0–9 每类 12 张)。点下面的例子或自己输入一句话,看 CLIP 找图~

🧠 CLIP 脑内怎么找?
🧠 CLIP 可视化训练器:让「字」和「图」在同一个空间里对齐
📚 训练数据 · 图文配对 120 对

每张真 MNIST 手写图配一句它的“名字”(7 / seven / 七…)。CLIP 不背标签——它只从“配对”里自己发现:长得像 7 的图和「7 的话」应该贴在一起。

🧪 测试数据集 · 考卷 80 张 · 没读过

这些也是真 MNIST,但训练时一次都没喂过(考卷)。CLIP 要是真学会了“数字的样子 ↔ 名字”的规律,没读过的也能认对;要是只会死记硬背就全错。

👆 点上面的图,考考它对没读过的图认不认识。
已预训练
📉 损失 🔢 步数 0 🎯 文字搜图命中
🖼️ 手写图 →〔图片编码器 49→32→49〕→ 向量 + 🔤 配文 →〔文字编码器:每个数字一个词向量〕→ 向量 → ⚖️ 点积 = “搭不搭”(49 = 把 7×7 个小格的亮度排成一排的 49 个数)
🎯 对齐矩阵:训练点亮对角线 ╲
行 = 喂进去的 10 张图(每次会换一张新的手写样本)· 列 = 0-9 的“文字名字” · 格子越深黄 = 这张图越像那句文字。训练会把配成对的对角线越拉越亮,把错配的格子推开(这就是 CLIP 的招牌:对比学习)。
🗺️ 向量空间:文字飞向它的图
小点 = 120 张手写图(颜色 = 它是数字几)· 带数字的圈 = 0-9 的“文字”,压在它那团同色图的正中央。坐标轴是每次实时算出的两个方向(专门挑「最能把大家摊开」的方向,真实模型里这些方向也是训练学出来的)。没学会时大家混成一团;每学一步,图就朝自己的数字圈聚拢,最后聚成 10 个清清楚楚的“数字窝”——这就是文字和图在同一个空间里“对齐”
📉 对比学习损失(越低越好)——喂的「图+配文」对越多,CLIP 越能“看字认图”,到上面的「文字搜图」里一搜就准。页面默认是已预训练的(所以开箱就能搜);想亲眼看它从头学,直接点「🎬 从零开始训练」——它会先重置成“没学过”,你再看着损失往下掉、对齐矩阵的对角线亮起来。

❓ 小测验 · 你学会了吗?

点选答案,答对会变绿、答错会变红(可重试)~

Q1. 「多模态 AI」的意思是?

Q2. 「文生图」是让 AI 做什么?

Q3. 2023 年起,AI 最大的进步是什么?

Q4. 在迷你 CLIP 实验室里,图库里有多少张手写数字?

Q5. 图库里那些手写数字,CLIP 事先知道「这是几」吗?

Q6. CLIP 是怎么学会把「字」和「图」对上的?

Q7. 在向量空间里,怎么判断一张图和一句话「搭不搭」?

Q8. CLIP 从没学过「偶数」这个词,为什么也能听懂?

🏁 回顾与完课 · 为自己盖章

我从故事里记住了一个新知识我能把这个故事讲给家人听我完成了一次小任务挑战我想把这一站和下一站连起来想一想

💭 思考一下:如果 AI 既能看、又能听、还能画,它最可能帮你完成哪一件「大事」?

🏅

人工智能简史 · 完课证明

小小学员 完成了 本站多模态 AI:看得见、听得懂、画得出

学会:AI 长出了「眼睛、耳朵和画笔」

第 14 站
已完课