← 返回课程 🛰️ E04 · 第15课 2024 年 · 人工智能简史 🎬 生成式 AI · 文生视频文生视频(Text-to-Video)用一句话直接生成一段视频——是生成式 AI 在「写字、画图」之后又会的一门手艺。层级:人工智能 ⊃ 机器学习 ⊃ 深度学习 ⊃ 生成式 AI(视频)本站在这一门里的位置:2024 年 Sora 公布,生成式 AI 正式走进「拍视频」。

🎬 Sora:一句话,生成一段视频

🎯 认识 2024 年 OpenAI 推出的文生视频模型 Sora——输入一句话就能生成逼真视频,还能模拟真实的物理世界
2024 🎬 第 15 站 / 16 · 2024 年

Sora:一句话,生成一段视频

OpenAI 推出文生视频模型 Sora,物理世界模拟能力突破。
🎯 本课目标:认识 2024 年 OpenAI 推出的文生视频模型 Sora——输入一句话就能生成逼真视频,还能模拟真实的物理世界

🕰️ 故事时间 · 那时候发生了什么?

2024 年 · 🎬
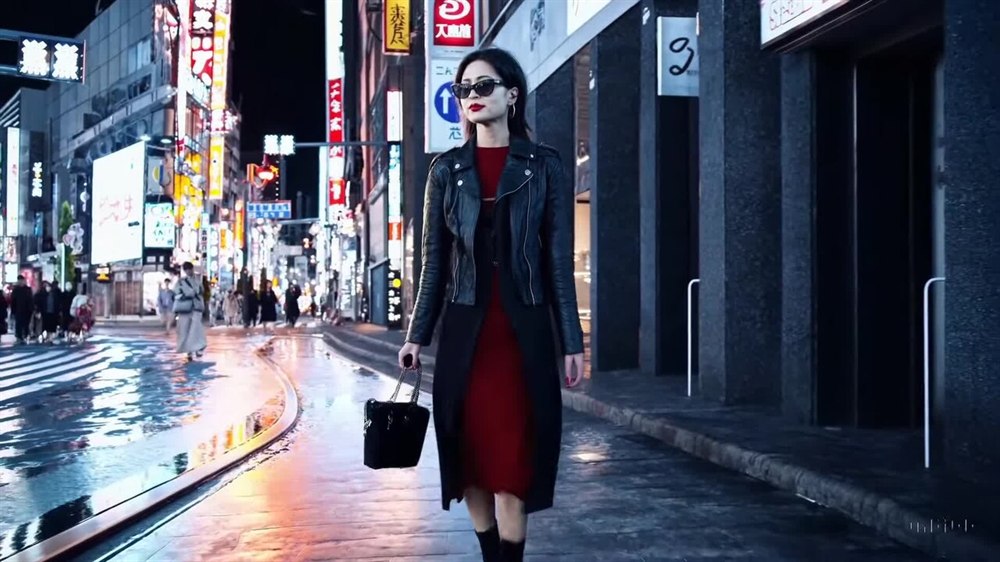
Sora 生成的电影感画面:夜晚霓虹灯下走在街上的行人
一句话,就是一段有电影感的视频——这是 OpenAI Sora 生成的真实画面

🖼️ 图片:OpenAI Sora 生成的视频画面(公有领域)· Wikimedia Commons
2014 年 · 从认图到画图
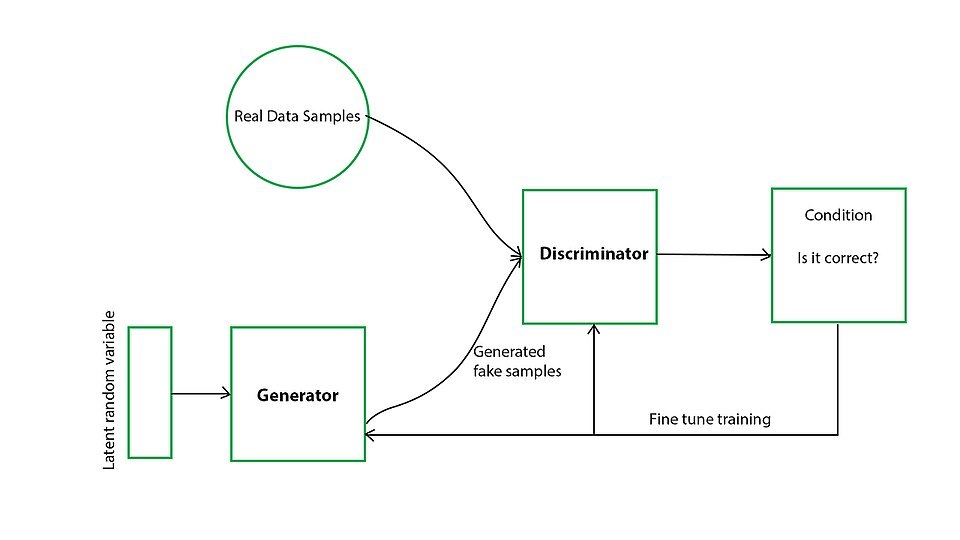
生成对抗网络结构图:生成器造出假样本,判别器判断真假
一个 AI 负责画,一个 AI 负责挑毛病,两个一起练。背景 ① · GAN 生成对抗网络 · CC BY-SA 4.0

AI 先学会了「认图」——看一眼就能说出「这是猫」。可人们更想让它自己。2014 年,研究者伊恩·古德费洛想出「生成对抗网络(GAN)」:让两个 AI 组队,一个拼命画(生成器),一个拼命挑毛病(判别器)。画的一直改、挑的一直评,画出来的东西就越来越像真的——这是 AI 第一次能「画」出这么像真的东西。
2021 年 1 月 · 文字变成图画
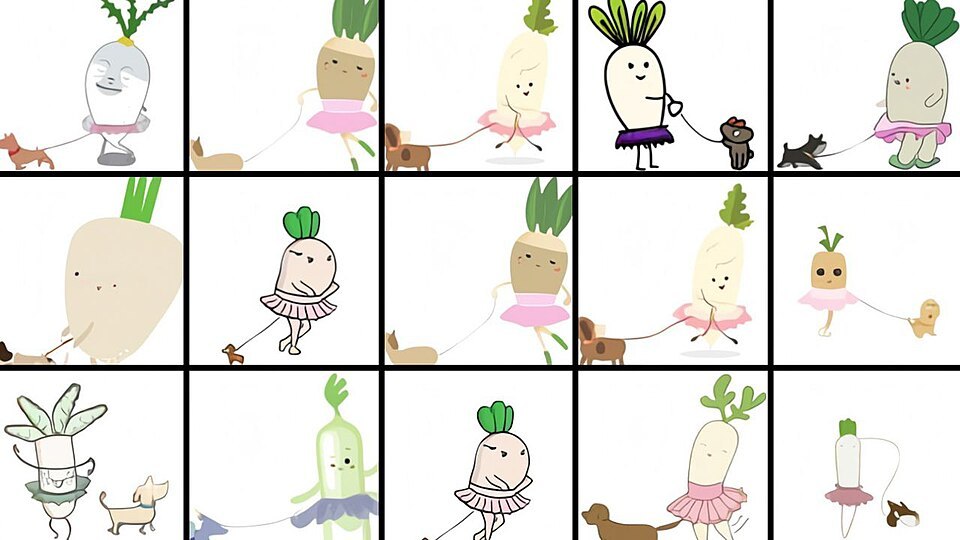
2021 年 DALL·E 用同一句提示画出的多张萝卜图画
DALL·E 按「穿裙子的萝卜」这一句提示画出的作品——同一句话,能变出好多版本。背景 ② · 文生图诞生 · 公有领域

2021 年 1 月,OpenAI 发布了 DALL·E:你打一句文字,它还给一张图画。「穿裙子的萝卜」「长着牛油果身体的扶手椅」……这些古怪要求它都画得出来,「文生图」就这样诞生了。不过这时候的图还有点像卡通,普通人也用不上。
2022 年 · 人人能画
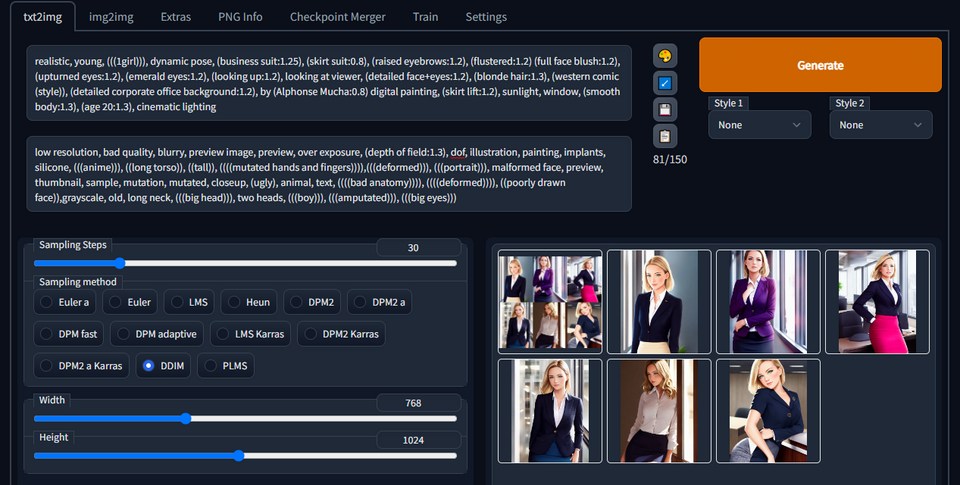
Stable Diffusion 的操作界面:左边填写文字和参数,右边出图
Stable Diffusion 的操作界面:左边填文字、拉滑条,右边就出图。背景 ③ · 免费开源工具 · Apache 2.0

2022 年,画图的 AI 突然变得「人手一份」:8 月,Stable Diffusion 把模型免费开源,谁都能下载到自己电脑上用;Midjourney 打开网页就能玩。图片也从「卡通感」升级成了照片级。一夜之间,很多插画、海报、头像都变成了 AI 画的。
2023 年 · 让画面动起来
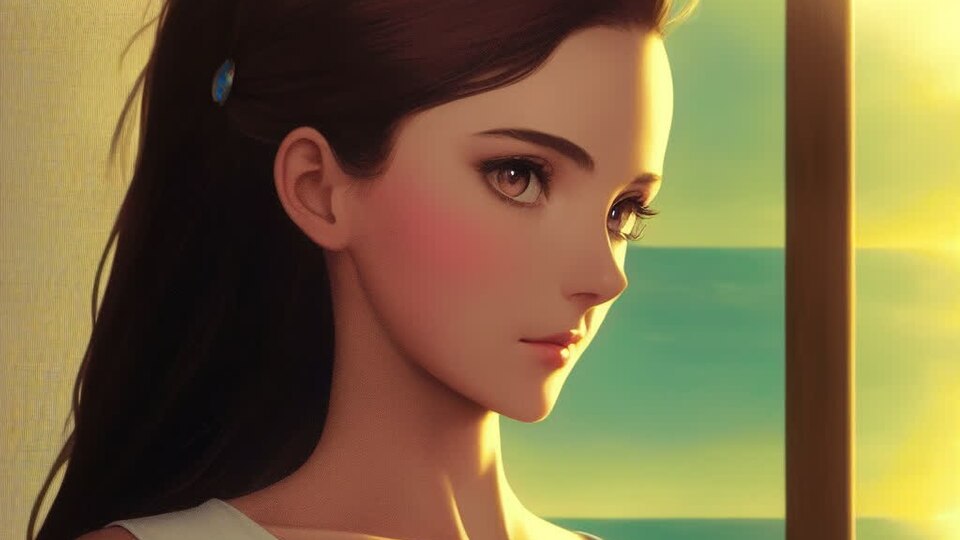
2023 年前后 AI 生成的动画画面:能动了,但脸和动作还不稳定
早期 AI 生成的动画画面:能动起来了,但脸和动作常常不稳定。背景 ④ · 文生视频的难题 · CC BY-SA 4.0

图能画了,下一个问题自然就是:能不能让画面动起来?2023 年,一批「文生视频」工具冒了出来(Runway、Pika……),可它们只能生成几秒钟:人一走远就变形,动作也接不上。难在哪儿?视频是每秒二十几张图,每一张都得和前后接得上——这比画一张图难太多了。
2024 年 2 月 15 日 · 公布
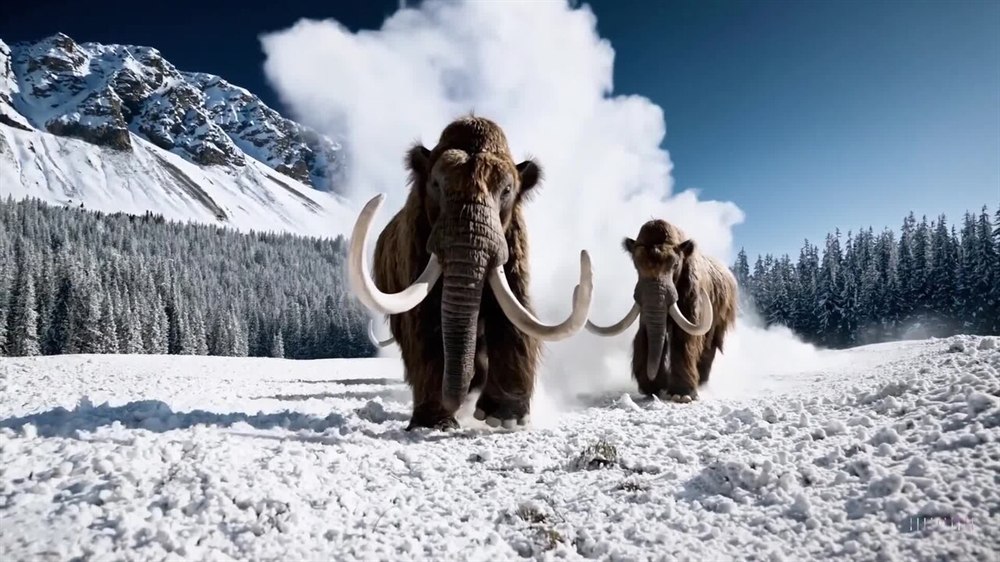
Sora 生成的画面:走在雪地里的长毛象
Sora 生成的画面:雪地里的长毛象。这种动物早就灭绝了,现实里根本拍不到。公布 · 2024 年 2 月 15 日 · Sora 生成

2024 年 2 月 15 日,OpenAI 公布了 Sora。它和以前的工具完全不同:只要一句话,就能生成最长约一分钟的视频——画面稳定、有电影感,镜头还会跟着人走。最让人吃惊的是,连早就灭绝的长毛象它都能「拍」出来。这一天,全世界都在讨论这个名字。
2024 年 2 月 · 它怎么做到的
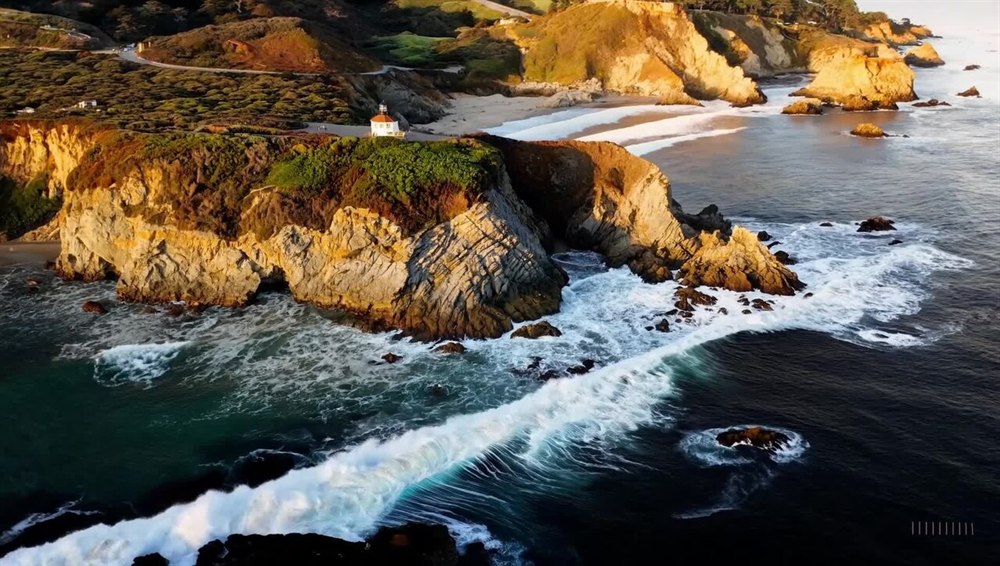
Sora 生成的海浪与海岸
Sora 生成的海浪:水怎么流、浪花怎么碎,它都算得出来。原理 · 世界模拟器 · Sora 生成

Sora 厉害在两个地方。第一,它把视频切成一个个小方块(连时间也算进去),再像拼积木一样,一块一块往后接。第二,看过的视频太多,它慢慢琢磨出现实世界的物理规律:东西会往下掉、水会流动、影子跟着光走。所以科学家说:Sora 更像一个「世界模拟器」,而不只是视频工具。
2024 年 12 月 9 日 · 正式开放
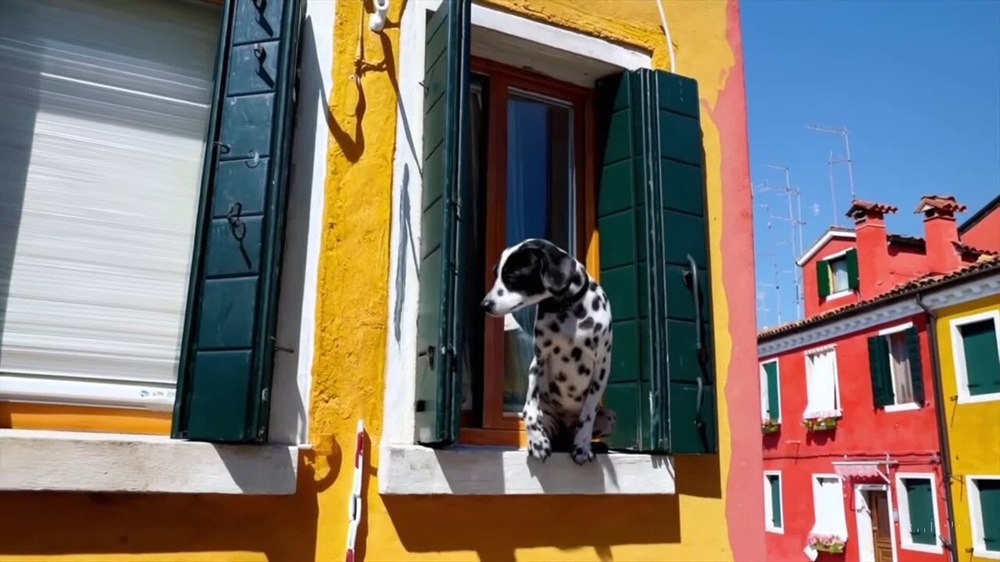
Sora 生成的意大利小镇窗台上的斑点狗
Sora 生成:意大利小镇窗台上的斑点狗——它的一条演示视频。发布 · 2024 年 12 月 9 日 · Sora 生成

刚亮相时,Sora 只能排队申请试用。直到 2024 年 12 月 9 日,它才正式对外开放:ChatGPT 的付费用户输入一句话、等上几分钟,视频就出来了。它的一条演示里,一只斑点狗蹲在意大利小镇的窗台上——那条片子被很多人转发。从此,「文生视频」从新闻里的黑科技,变成了人人可用的工具

它还在学习
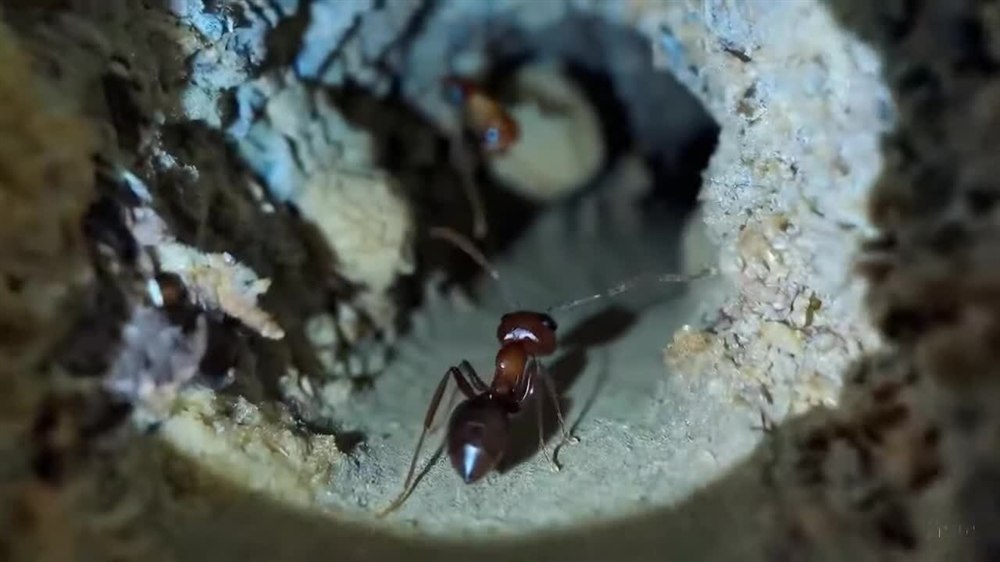
Sora 生成的蚂蚁视角镜头
Sora 生成的「蚂蚁视角」镜头——很酷,但仔细看,它的腿有时会多出几条。它还在学习 · Sora 生成

不过 Sora 也会犯迷糊:人走过桌子,手指可能「穿过」杯子;画面里人一多,它甚至数不清有多少条腿。因为真实世界太复杂,它学得还不够多。所以看到特别离奇的视频,不妨多看两眼、想一想——这也是 AI 时代我们要练的本事。
✨ 最终影响
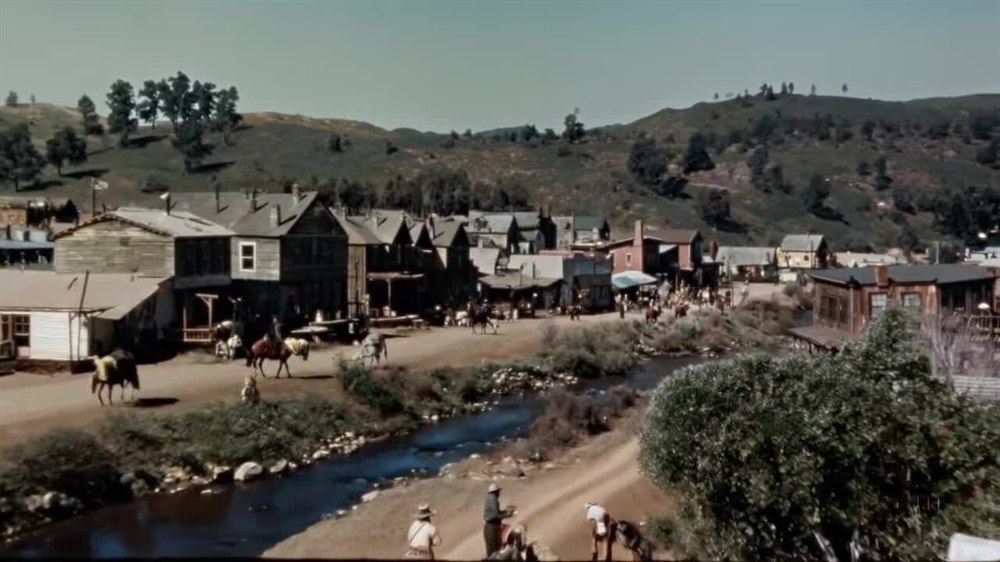
Sora 生成的淘金热小镇场景
① 历史片:Sora 生成的「淘金热」小镇——不用搭景、不用演员。Sora 生成
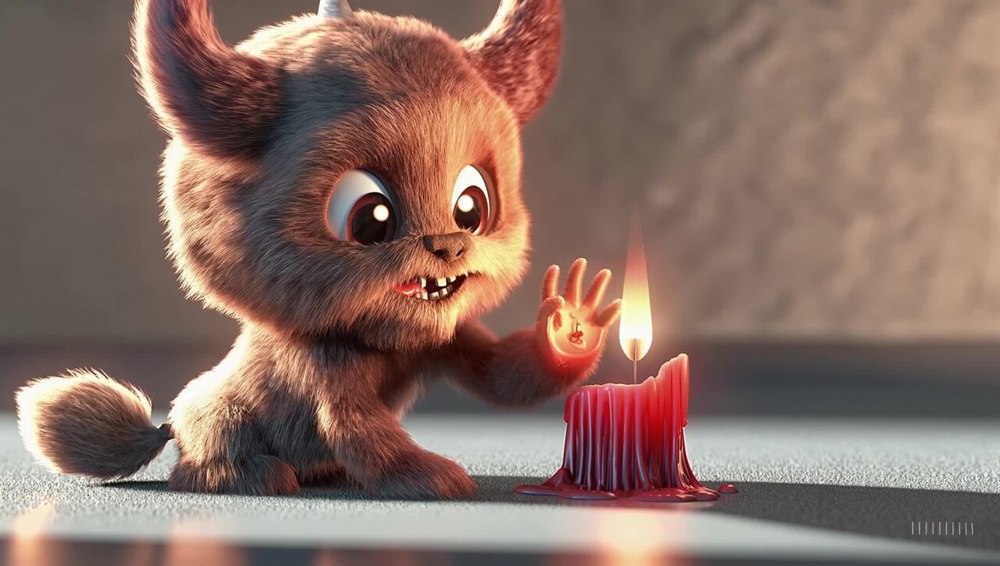
Sora 生成的卡通小怪物和蜡烛
② 动画片:Sora 生成的卡通角色——不用画分镜、不用做模型。Sora 生成

Sora 让全世界第一次看到:把脑子里的想法说出来,AI 就能把它「」成一段视频。广告、动画、教学片、小电影……做视频的门槛一下子低了。不过新问题也跟着来了——既然视频也能凭空造出来,以后看到的东西,我们还能相信吗?

🖼️ 图片:GAN 结构示意图(CC BY-SA 4.0)、DALL·E 生成的图画(公有领域)、Stable Diffusion 操作界面截图(Apache 2.0)、早期 AI 生成动画画面(CC BY-SA 4.0),以及多张由 OpenAI Sora 生成的视频画面(公有领域)——均为真实技术图纸 / AI 生成作品 / 软件界面截图,仅作教学使用

📖 知识小课堂 · 记住这个魔法!

点击卡片翻开,看看背后的知识~

文生视频👆 点我翻开
输入一句话 → 生成一段会动的视频
💡世界模拟器👆 点我翻开
不只画画面,还尝试理解重力、光影、运动等物理规律
🔑还在学习👆 点我翻开
偶尔会犯「手指穿过杯子、人数不清腿」这类小错误
🎭两个 AI 对着练👆 点我翻开
2014 年古德费洛的 GAN:一个拼命画,一个拼命挑毛病,越练越像
🥕文生图诞生👆 点我翻开
2021 年 1 月 DALL·E:说「穿裙子的萝卜」,它给你一幅画
🆓人人能画👆 点我翻开
2022 年 8 月 Stable Diffusion 免费开源,图片升级到照片级
视频为什么难👆 点我翻开
视频每秒二十几张图,每一张都得和前后接得上,比画一张难太多
🎬Sora 登场👆 点我翻开
2024 年 2 月 15 日公布:一句话生成最长约一分钟、画面稳定的视频

🖐️ 动手试一试 · 扩散模型可视化

扩散模型实验室生成式 AI 的基础算法 · 先把图画“搅浑”,再一步步“捞”回来

🧩 它分两半:加噪与去噪

① 正向 · 加噪把清晰图片一点点加上噪点,直到变成一团“雪花” ② 训练 · 学去噪模型看着“加噪前后”,学着把噪点去掉 ③ 反向 · 去噪生成从纯噪点出发一步步还原,变出一张新图
🧪 正向 · 加噪
✨ 原图 · 完全清晰(t = 0)
🎛️ 噪声量 t = 0 / 100

把滑条往右拉 = 正向加噪:画面被噪点越盖越多,最后变成一团雪花。

🔑 一分钟搞懂扩散模型

  • 🎯 加噪:把原图一步步“搅浑”成纯噪点——训练时用来出题。
  • 🧠 学去噪:模型看到“加了噪的图”,练着猜出噪点并去掉,学会把画面捞回来。
  • 去噪生成:生成时从一张随机噪点出发,一步一还原,最后“长”出一张全新图片。
  • 🖼️ 文生图、文生视频这类生成式 AI,很多都以扩散模型当引擎。

💡 诚实小贴士:真正的模型看过成千上万张图才会“去噪”;这里为了演示,把“去噪”简化成一步步回到原图的过程。

🧭 二维空间 · 从「一点噪声」生成「一只猫」

把它想成一个二维「图像空间」:原点附近 = 随机噪声,越往外越接近真实的照片——猫聚在右上、狗在左上。看 AI 怎么从原点的一点噪声,一步步「生成」出一张猫的照片。

🌫️ 原点:一团随机噪声

① 原点:一团随机噪声,什么也看不清。
② 过程:噪声朝「猫的照片」方向走,一边走一边去噪。
③ 终点:变出一张清晰完整的猫照片。

🦢 折纸版扩散模型 · 揉皱 ⇄ 抚平

把「图像」想成一只折好的千纸鹤:正向=把它一步步揉成随机纸团(高斯噪声 xT),逆向=「折纸大师」(去噪网络)一步步抚平褶皱,让折痕结构重新「显影」。条件决定折成什么,纸团的随机褶皱决定具体细节。

折好的千纸鹤 x₀(干净图像)
🎯 条件(想折成什么):

折纸对照:干净图像=千纸鹤 | 噪声=纸团 | 去噪网络=折纸大师 | 分数函数(往哪个方向抚更像折纸的「指南针」) | 条件=“我要折猫” | 多步=先抚大褶皱、再精修细节

❓ 小测验 · 你学会了吗?

点选答案,答对会变绿、答错会变红(可重试)~

Q1. Sora 最特别的本领是什么?

Q2. 为什么科学家说 Sora 像「世界模拟器」?

Q3. Sora 偶尔会犯的错,下面哪个是对的?

Q4. 扩散模型分成哪两半?

Q5. 扩散模型「生成」一张新图,是从什么出发的?

Q6. 那个折纸演示里,「去噪网络」被比作什么?

Q7. 折纸演示里,那个滑条从 0 拉到 100 代表什么?

Q8. 为什么做视频比画一张图难得多?

🏁 回顾与完课 · 为自己盖章

我从故事里记住了一个新知识我能把这个故事讲给家人听我完成了一次小任务挑战我想把这一站和下一站连起来想一想

💭 思考一下:如果 Sora 能把你说的话变成视频,你最想让它拍什么?为什么这段画面对你很有意义?

🏅

人工智能简史 · 完课证明

小小学员 完成了 本站Sora:一句话,生成一段视频

学会:OpenAI 推出文生视频模型 Sora,物理世界模拟能力突破。

第 15 站
已完课