← 返回课程 🛰️ E04 · 第16课 2025 年 · 人工智能简史 🤖 智能体(AI Agent)智能体(AI Agent)不只会回答问题,还能自己定计划、调用工具、动手把事情做完的 AI。层级:人工智能 ⊃ 机器学习 ⊃ 深度学习 ⊃ 大模型 ⊃ 智能体。让它住进会动的身体,就叫「机器人 / 具身智能」。本站在这一门里的位置:2024 年 MCP 统一了「工具插口」,2025 年 OpenClaw 让它真的能操作电脑和手机。

🦾 OpenClaw:会自己用手机电脑的 AI 助理

🎯 认识 2025 年爆火的开源智能体框架 OpenClaw——能操控手机、电脑,跨 App 协同,真正替你「跑腿干活」
2025 🦾 第 16 站 / 16 · 2025 年

OpenClaw:会自己用手机电脑的 AI 助理

开源多模态智能体框架,实现手机/电脑自动化操作与跨应用协同,迅速成为 AI Agent 领域现象级项目。
🎯 本课目标:认识 2025 年爆火的开源智能体框架 OpenClaw——能操控手机、电脑,跨 App 协同,真正替你「跑腿干活」

🕰️ 故事时间 · 那时候发生了什么?

2025 年 · 🦾
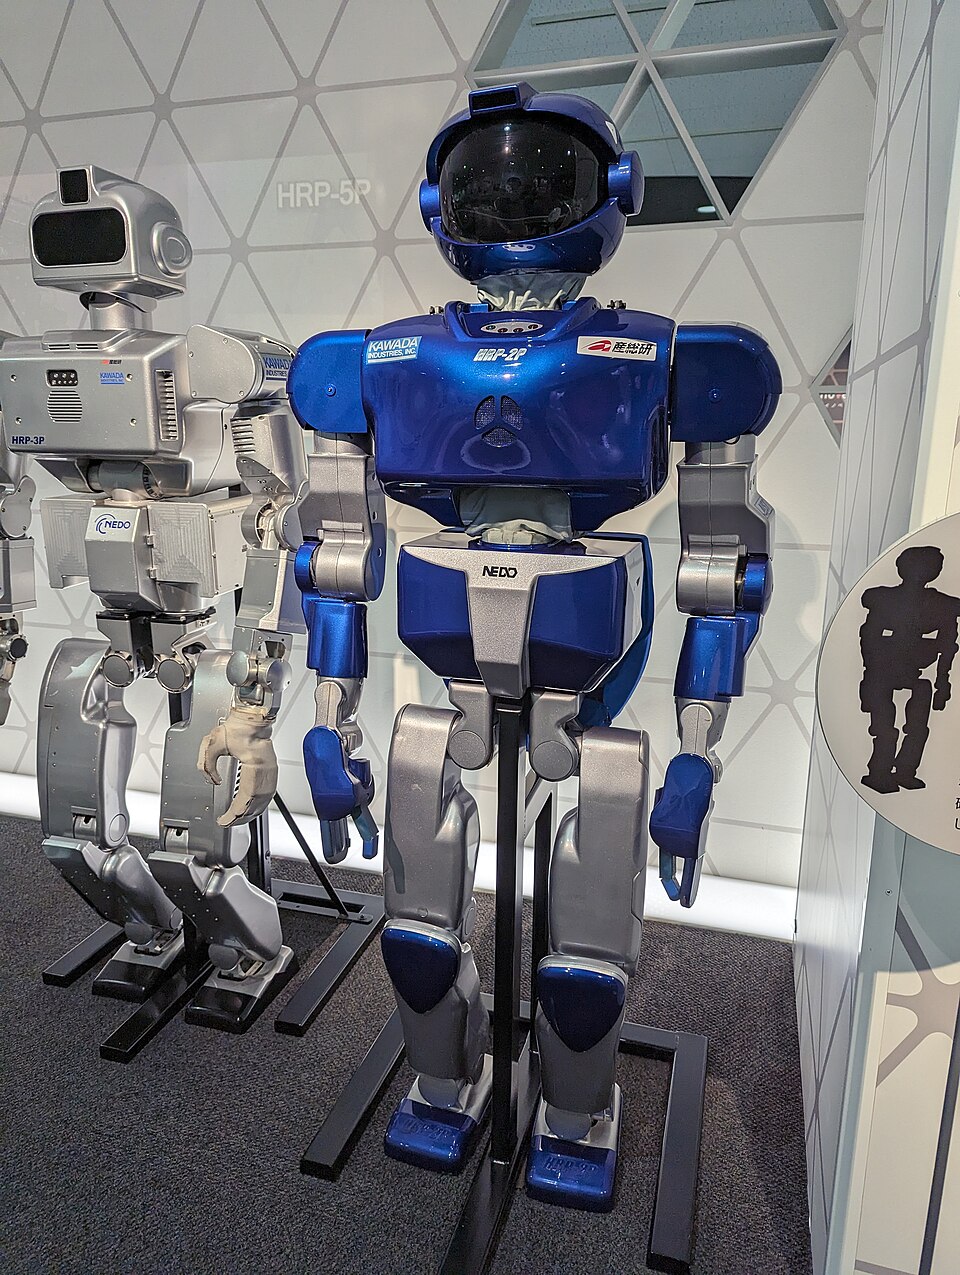
会动手干活的人形机器人
智能体时代:它会「看」屏幕、会点按钮,替我们把手机和电脑上的事一件件办完(机器人身体里住的,也是同一个「大脑」)

🖼️ 图片来源:公有领域 · Wikimedia Commons

2000 年代 · 只会照剧本办事
实验室里反复做同一套动作的机械臂
机械臂只会一遍遍重复写好的动作:换个位置、换个任务,它就得重新教一遍。背景 ① · 只会照剧本办事 · 公有领域

人们早就想让机器替自己干活。可那时候的「自动」都靠人把步骤一条条写死:点哪个按钮、往哪一格填字,全得提前规定好。它也只会重复同一套动作——界面一变、按钮一挪,它就傻在那儿。会「照剧本演」,但不会自己想办法。
2011 年 — 2016 年 · 会听话,但不会动手
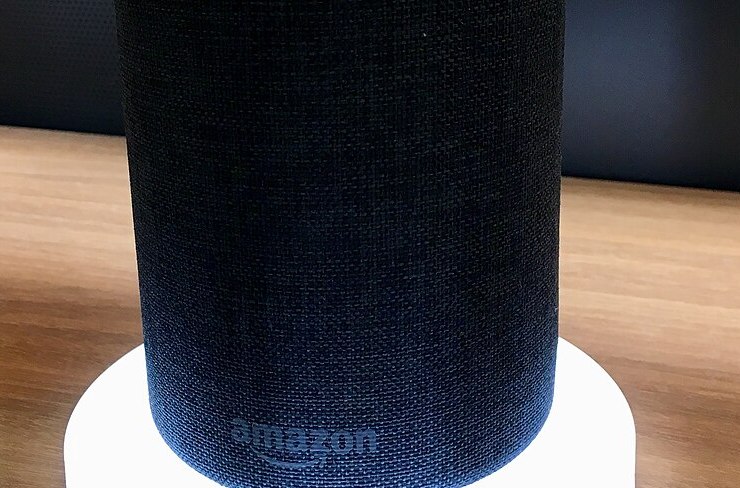
能听会说的智能音箱
2014 年上市的智能音箱 Amazon Echo:能答话、能放音乐,可没预设过的事它就做不了。背景 ② · 会听话 ≠ 会动手 · CC BY-SA 2.0

2011 年,手机上的语音助手出现了:你说话,它听得懂,还能帮你定闹钟、查天气;后来家里又多了能放在桌上的智能音箱,喊一声就能放歌、开灯。可它们只会做那几件提前定好的事。你说「帮我订张票」「把作业发给老师」,它多半只能回答一句:「抱歉,我还不会。」——会说话,不等于会干活。
2022 年 11 月 30 日 · 长出会说话的「大脑」
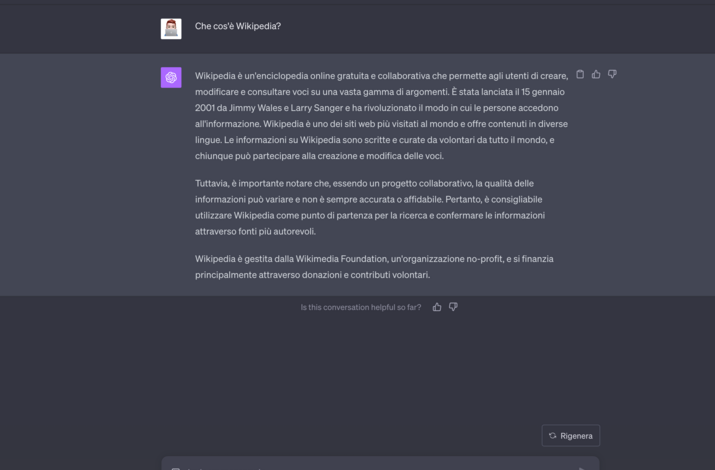
ChatGPT 对话界面:你问什么它都能答上来
ChatGPT 刚上线时的样子:你问什么它都能答上来,像一个会说话的「大脑」。背景 ③ · ChatGPT 界面截图 · CC BY 3.0

2022 年 11 月 30 日,ChatGPT 上线。它和以前的助手很不一样:你想问什么都能问,它像读过很多书的人一样答得上来,还能写作文、写代码、翻译、解释概念——人们第一次觉得:AI 好像有了一个会思考的「大脑」。可它还是只能待在聊天框里:会说,但不会动手。(第 13 课里我们看过:它是到 2024—2025 年才学会「边想边说」的。)
2023 年 3 月 · 诞生:AI 第一次自己定计划
AutoGPT 项目的标志图案
AutoGPT 的标志。「你给目标,它自己想办法」就是从它开始流行起来的。诞生 · 2023 年 3 月 · CC BY-SA 4.0

2023 年 3 月,一个开源项目 AutoGPT 突然火遍全网。你只要给它一个目标,它就会自己把大目标拆成一小步一小步:自己上网查资料、自己写文件、自己回头看「这一步成没成」,做错了再换个办法。AI 第一次从「你问一句、它答一句」,变成「你定目标、它自己跑完」——大家给这样的 AI 起了个名字:智能体(Agent)

2024 年 11 月 · 给智能体统一「工具插口」
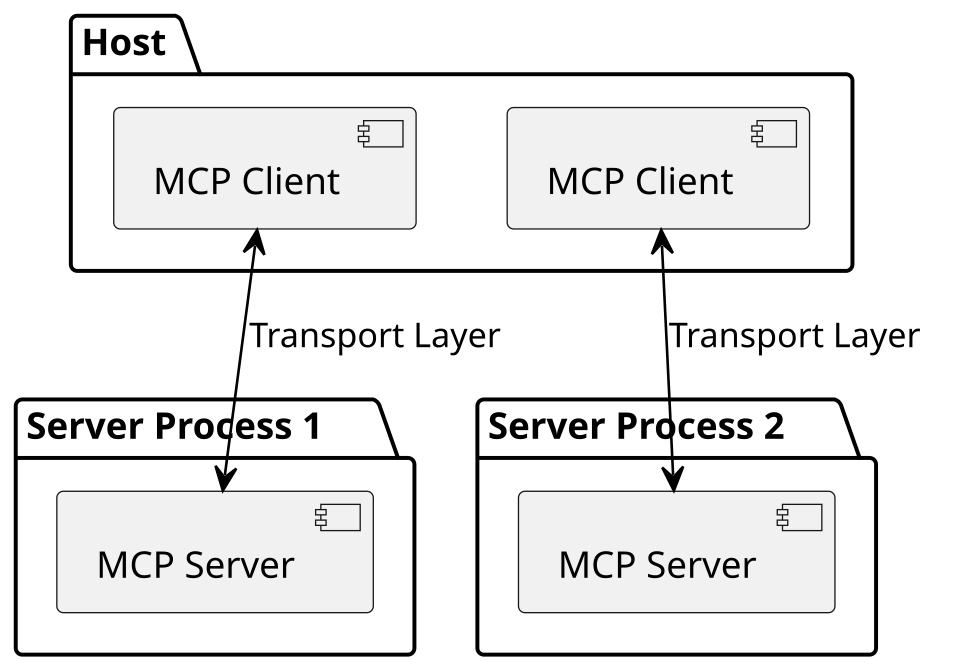
MCP 组件图:一个 Host 里跑着多个 MCP Client,分别连到不同的工具服务器
MCP 像「统一的插口」:把各种各样的工具接到智能体身上。关键节点 ① · MCP 官方组件图 · MIT

智能体要干活,就得会「用工具」:查天气、算数、读文件、发消息……可每接一个新工具都要重做一遍,太麻烦了。2024 年 11 月,Anthropic 公司公开了一个叫 MCP(模型上下文协议)的开放标准:它把各种各样的工具都做成同一种规格。从此智能体接工具,就像给手机插上充电线一样方便——工具越多,它能替你办的事就越多。
2025 年 · 智能体走进手机,人人都能派活儿
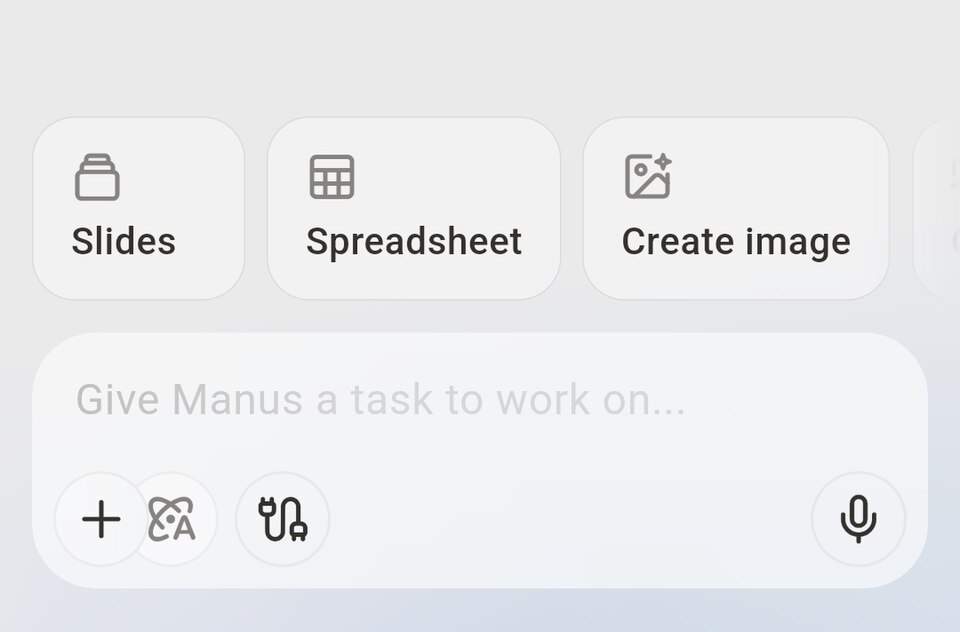
手机上的智能体 App:直接输入任务,就能让它做幻灯片、表格、图片
手机上的智能体 App:写一句话派活儿,它能自己做幻灯片、表格、图片。关键节点 ② · Manus 智能体 App · 公有领域

到了 2025 年,智能体开始变成普通人也能用上的产品(比如手机上的智能体 App)。你写一句「帮我做一份春游计划的幻灯片」,它会自己找资料、自己排版、自己生成文件,你只要最后检查一下;做表格、画图、写报告,也都可以直接「」给它。请 AI 干活,从此不再是程序员的专利。

2025 年 · OpenClaw 发布:开源 + 跨 App 协同
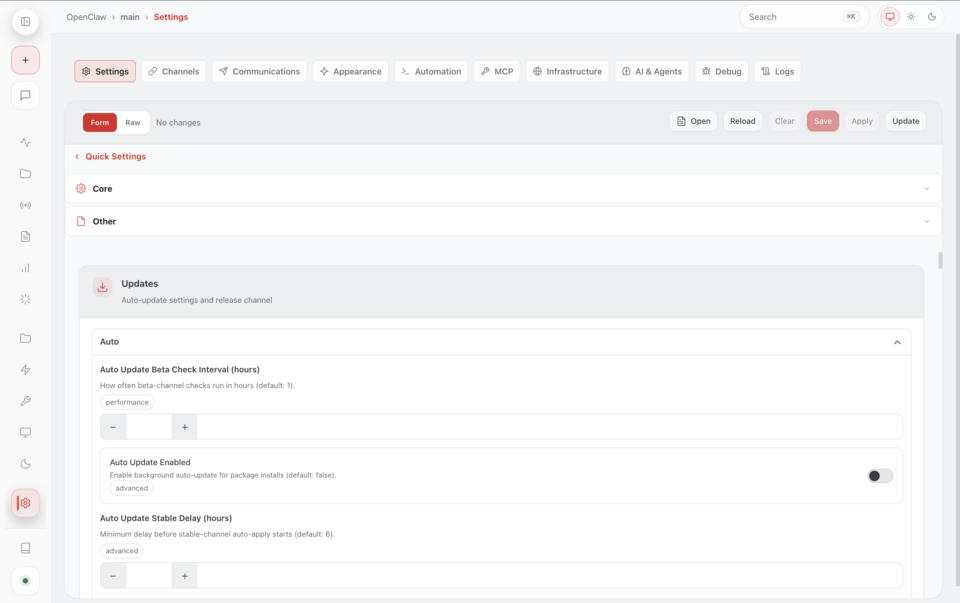
OpenClaw 的界面:通道、自动化、MCP、AI 与智能体等设置项
OpenClaw 的真实界面:通道、自动化、MCP、AI 与智能体……工具和技能都能一个个接进来。发布 · 开源智能体框架 · MIT

2025 年,开源项目 OpenClaw 又往前走了一大步(在它之前,2024 年 10 月起已经有「会用电脑」的智能体——AI 第一次学会看着屏幕自己动手):它能让 AI 直接看着手机和电脑的屏幕,自己找到按钮、点下去、打字、拖文件;更厉害的是「跨 App 协同」——你说「把相册里的小狗照片发给妈妈,再在日历里记下周六野餐」,它会自己依次打开相册、微信、日历,一件件办完。因为开源,全世界的开发者都能给它添砖加瓦,它很快成了智能体圈里的「现象级明星」。
✨ 最终影响:从「会回答」到「会办事」
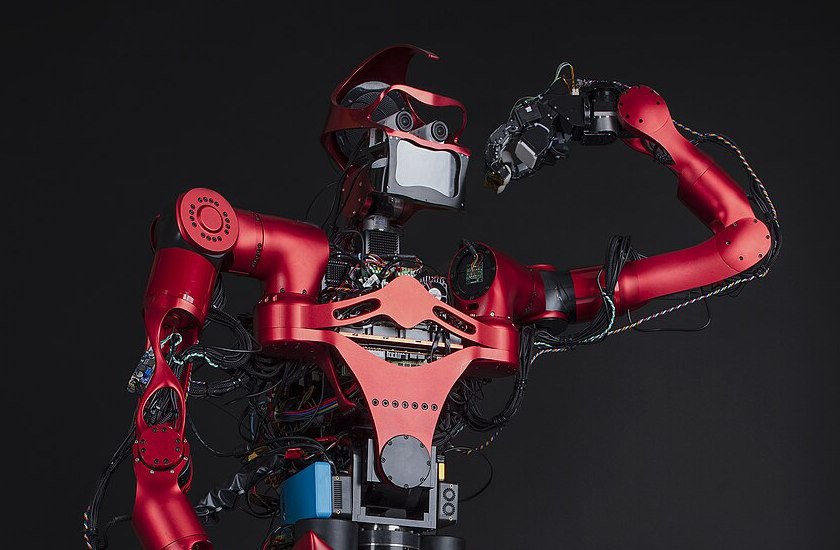
实验室里的人形机器人:会看、会想、会动手
会看、会想、会动手——智能体不只在屏幕里,机器人也在长出「智能体大脑」。影响 · 人形机器人 TOCABI · CC BY-SA 4.0

智能体把三样本事凑到了一起:会思考的「大脑」、会看会听的「眼睛和耳朵」、会操作屏幕的「」。所以它不再只是回答问题,而是能真的替你把一件事办成。这股力量还在走出屏幕——今天的人形机器人背后,也常常住着一个会看、会想、会动手的智能体。AI 的下一个时代,属于「会办事」的 AI。

🖼️ 图片:实验室机械臂(NIAID,公有领域)、智能音箱 Amazon Echo(The Unwinder,CC BY-SA 2.0)、ChatGPT 界面截图(Lugab89,CC BY 3.0)、AutoGPT 标志(AutoGPT 开发团队,CC BY-SA 4.0)、MCP 官方组件图(modelcontextprotocol,MIT)、Manus 智能体 App 截图(公有领域)、OpenClaw 界面截图(OpenClaw 项目,MIT)、人形机器人 TOCABI(Cadop,CC BY-SA 4.0)——图片文件均取自 Wikimedia Commons,其中的软件界面与标志版权归各自产品所有,仅作教学使用

📖 知识小课堂 · 记住这个魔法!

点击卡片翻开,看看背后的知识~

开源智能体框架👆 点我翻开
OpenClaw 是开源的多模态智能体框架,人人都能用、能改进
💡自己操作屏幕👆 点我翻开
看屏幕、找按钮、点击输入——像人一样操作手机和电脑
🔑跨应用协同👆 点我翻开
一个任务能跨好几个 App 自动完成:选照片 → 发消息 → 记日程
📜以前只会照剧本👆 点我翻开
2000 年代的「自动」靠人把步骤一条条写死,界面一变它就傻在那儿
🗣会说话≠会干活👆 点我翻开
2011 年起的语音助手、智能音箱,只会做提前定好的那几件事
🎯你定目标,它自己跑👆 点我翻开
2023 年 3 月 AutoGPT:自己把大目标拆成一小步一小步,做错了再换办法
🔌统一的工具插口👆 点我翻开
2024 年 11 月 Anthropic 公开 MCP,把各种工具做成同一种规格
🧠大脑 + 眼睛 + 手👆 点我翻开
会思考的大脑、会看会听的感官、会操作屏幕的手,凑成会办事的 AI

🖐️ 动手试一试 · 智能体(Agent)操作实验室

OpenClaw 智能体驾驶舱真实大模型驱动 · 看它一步步「思考 → 规划 → 用工具 → 记忆」

🧩 什么是智能体(Agent)? 先看懂定义与 4 大能力,再看下面它真怎么干活

🖥️ 电脑 / 现实环境
🤖智能体
执行器
传感器
🗂️各种资源(用户、文件、etc)
🧠LLM大模型 · 会思考的“大脑”
🗒️ 用户只给一句话:「算出本周六是几月几日,再倒推提前 2 天准备的时间。」
剩下的拆步骤、算结果、检查对不对,都由它自己完成。
(真实智能体还能看屏幕、点鼠标;本站实验室只开放下面 5 个小工具,先看清它的「思考 → 规划 → 用工具 → 记忆」闭环。)

📚 智能体的权威定义(学术界)

智能体(Agent)是指任何能够通过传感器(Sensor)感知环境、并通过执行器(Actuator)对环境采取行动以实现目标的实体。—— Stuart Russell & Peter Norvig《人工智能:一种现代方法》

🔁 一个完全的自主智能体,必须具备 4 大核心闭环能力

  • 👁️
    感知Perception

    接收环境的多模态信息:文字、图片、声音、屏幕内容。

    = 下面流程图里的「看屏幕 · 听声音」
  • 🗺️
    推理与规划Reasoning & Planning

    把大目标分解成可执行的多步子任务。

    = 下面流程图里的「🗺️ 规划」
  • 🛠️
    工具调用Tool Use

    自主调用外部工具(搜索引擎、API、数据库、计算器)补信息或改变环境。

    = 下面流程图里的「🛠️ 工具使用」
  • 💾
    记忆与反思Memory & Reflection

    短期工作记忆 + 长期记忆,并能根据行动结果自我纠错。

    = 下面流程图里的「💾 记忆」

✅ 关键判定标准:目标驱动 + 自主行动——给它一个最终目标(如「帮我订下周二去北京的机票」),它自己决定执行路径,全程不需要人一步一步指挥。

🎯 给 OpenClaw 派个真实任务

🛠️ 它能调用的真实工具:计算器 · 日期时间 · 单位换算 · 文本统计 · 记忆本

🔄 智能体工作流程图 等待任务…

❓ 小测验 · 你学会了吗?

点选答案,答对会变绿、答错会变红(可重试)~

Q1. OpenClaw 是一款什么样的项目?

Q2. OpenClaw 最特别的本领是什么?

Q3. 「跨应用协同」指的是什么?

Q4. 智能体(Agent)的定义里,靠什么「感知环境」?

Q5. 智能体的 4 大能力里,「推理与规划」做的是什么?

Q6. 那个实验室里,OpenClaw 能调用几个真实工具?

Q7. 它把一个任务最多拆成几步来执行?

Q8. 它输出答案之前,最后一步做了什么?

🏁 回顾与完课 · 为自己盖章

我从故事里记住了一个新知识我能把这个故事讲给家人听我完成了一次小任务挑战我想把这一站和下一站连起来想一想

💭 思考一下:如果 AI 能替你操作手机和电脑,你会请它帮你做什么?又有哪些事,你更愿意自己做?

🏅

人工智能简史 · 完课证明

小小学员 完成了 本站OpenClaw:会自己用手机电脑的 AI 助理

学会:开源多模态智能体框架,实现手机/电脑自动化操作与跨应用协同,迅速成为 AI Agent 领域现象级项目。

第 16 站
已完课