🧠 感知机:第一台会学习的机器
🕰️ 故事时间 · 那时候发生了什么?
1957 年 · 🧠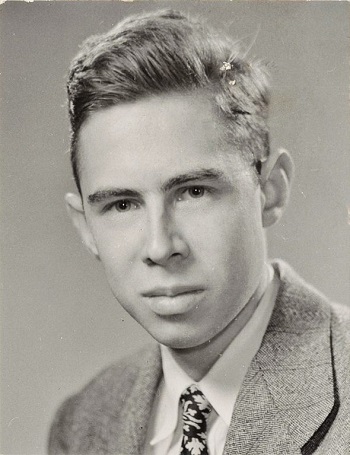
- 1928 年出生在美国,是心理学家也是计算机科学家
- 1957 年造出第一台把「从例子里学习」做成硬件、并轰动世界的机器——感知机
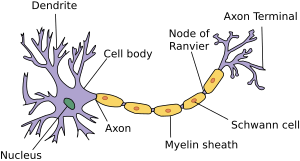
- 灵感来自大脑里的「神经元」
- 今天 AI 的「学习」,都源自他「拧动权重旋钮」的灵感
🖼️ 图片来源:CC BY-SA 4.0 · Wikimedia Commons
1928 年,弗兰克·罗森布拉特出生在美国。他既是心理学家,也是计算机科学家。小时候的他一定也好奇过:我们人是怎么认出东西、怎么学会新本领的呢?
答案就在脑子里。1943 年,麦卡洛克和皮茨第一次把「神经元」画成了一张可以计算的图;1949 年,心理学家赫布又发现:两个神经元如果总是一起点亮,它们之间的连接就会变粗——一起亮的,会连得更紧。罗森布拉特想:既然大脑是这么学的,能不能照着这张图纸,造一台会「学习」的机器?
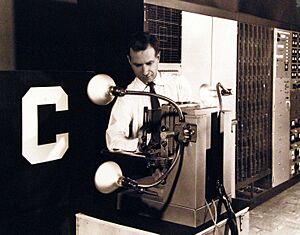
1957 年,罗森布拉特在康奈尔航空实验室真的把它造了出来——「感知机」。这个名字来自 perception(感知),是他自己起的。
它个头不大,看上去也不算聪明,却做成了一件全新的事:会根据经验改变自己的判断。美国海军很快出钱支持这项研究——他们想知道,这台机器将来能不能自己认路、认东西。
第二年,也就是 1958 年,消息登了报,全世界都轰动了。《纽约时报》的标题写着「海军的新装置会通过实践学习」,文章里还说:它将来也许能走路、说话、看东西,甚至能自己复制自己。
报纸把它吹上了天。可它当时真正会的,其实很朴素:认出简单的几何图形——三角形、正方形、圆形;同一个「A」多看几遍,它就能稳稳认出来,位置挪一挪、写得不一样,也照样认得。
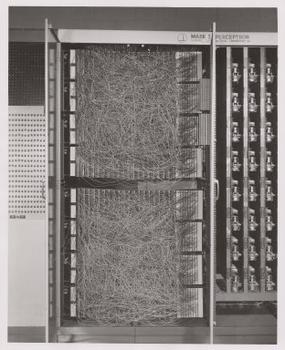
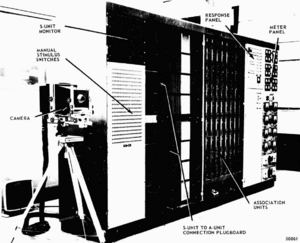
1960 年,他们真的把它造成了真机器——「Mark I 感知机」。
它有 400 只「眼睛」(排成 20×20 的光电池)、512 个中间单元,最后汇成 8 个输出。最特别的是它的「记忆」:一排排小马达带着电位器,真的在拧旋钮——这些旋钮,就是它的「权重」。

它是怎么学习的呢?先瞎猜一个答案;如果猜错了,就把自己内部的小旋钮「拧一点」——科学家把这个旋钮叫「权重」。
不用人把规则写给它,只要给它足够多的例子,它自己就越来越准。它不认识「规则」,只认识「例子」——这就是「学习」,今天所有 AI 的学习,都是从这样一圈一圈转出来的。

可是热情没有持续太久。1969 年,当年一起写提案的明斯基和帕佩特出了一本书,书名就叫《感知机》。他们用数学证明:单层感知机连「异或」这么简单的规则都学不会——用一条直线,永远画不出那个答案。书里还说,把感知机一层层叠起来也「没什么前途」。
这本书让全世界的热情迅速冷了下来:经费断了、论文没人看,AI 走进了第一次「寒冬」。更可惜的是,罗森布拉特没能等到它翻身——1971 年 7 月 11 日,他 43 岁生日那天,在划船时意外溺水去世了。
历史后来开了个大玩笑。1986 年,科学家发现:只要把感知机一层层叠起来,再用「反向传播」去训练它,异或根本不是问题(这个故事,第 6 课会细讲)。
从那以后,「一层叠一层」的神经网络越做越大:2012 年学会了认图,2022 年学会了聊天。今天的大模型有上千亿个「旋钮」——它们全都是罗森布拉特那个小旋钮的后代。
🖼️ 图片:罗森布拉特肖像、Mark I 真机照与操作手册部件图、新闻照、神经元图来自维基共享资源(经 kids.kiddle.co 镜像);其余四张示意图(它能认出什么 / 猜错了就拧旋钮 / 一盆冷水 / 一层不够就叠起来)均为本课自绘