🔁 反向传播:让神经网络学会纠错
🕰️ 故事时间 · 那时候发生了什么?
1986 年 · 🔁
🖼️ 图片来源:本课件自制示意图
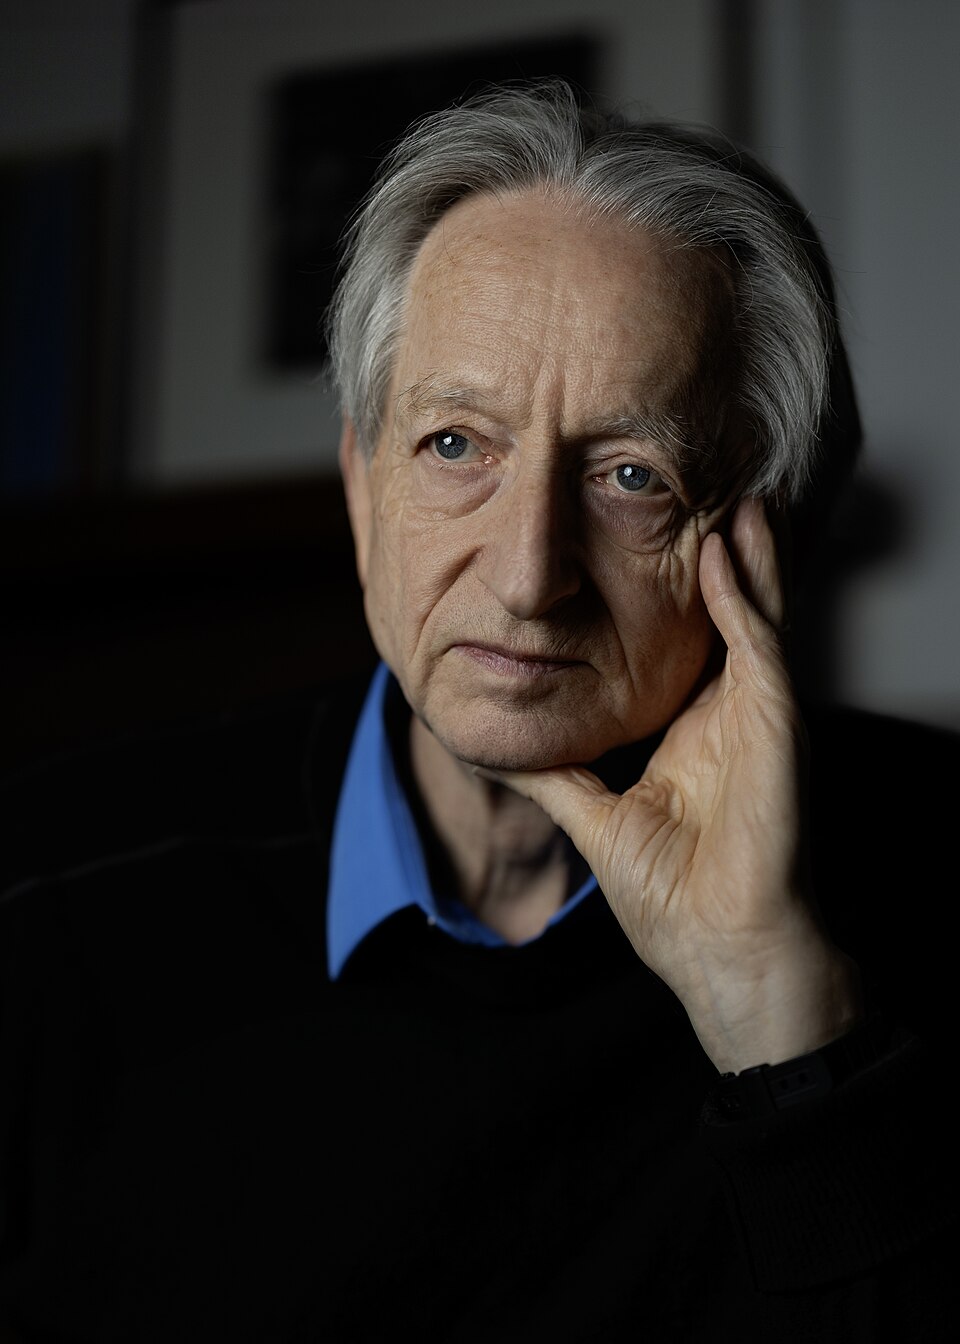
1947 年,杰弗里·辛顿(Geoffrey Hinton)出生在伦敦一个「科学世家」里:他的曾曾祖父,正是发明了“布尔代数”的数学家乔治·布尔。他先在剑桥学心理学,又到爱丁堡研究「机器能不能像大脑一样自己学」。
那时大多数科学家相信:要把知识一条条写进电脑。辛顿偏偏相信另一条路——把很多层「人工神经元」叠在一起,让机器自己从例子里学。

1969 年,明斯基和帕佩特出版了一本书《感知机》,指出一个严重的局限:单层感知机只能画一条直线,连「异或」都学不会(第 3 站我们见识过这个坑)。
那多叠几层呢?想法很美,可当时没人知道该怎么训练它——多层网络被当成一条走不通的死路,关注和经费都撕了。

就算把很多层叠起来,新问题马上冒出来:答案错了、负责的到底是第一层还是最后一层?每一层都可能有错,却看不清各自该改多少。
这个「责任分不清」的问题,把神经网络卡了将近 20 年。一直到 1986 年,才有人给出了一个漂亮的解法。

其实,「把误差倒着传」的数学工具早就有了。
1970 年,芬兰研究者 Seppo Linnainmaa 在他的硕士论文里提出了一种通用方法:把计算过程画成一张「图」,然后沿着箭头倒着走,就能高效地算出每一步的变化率(今天叫「反向模式自动微分」)。
这就是反向传播背后的算法引擎——只不过当时它还没有和「神经网络」连在一起。
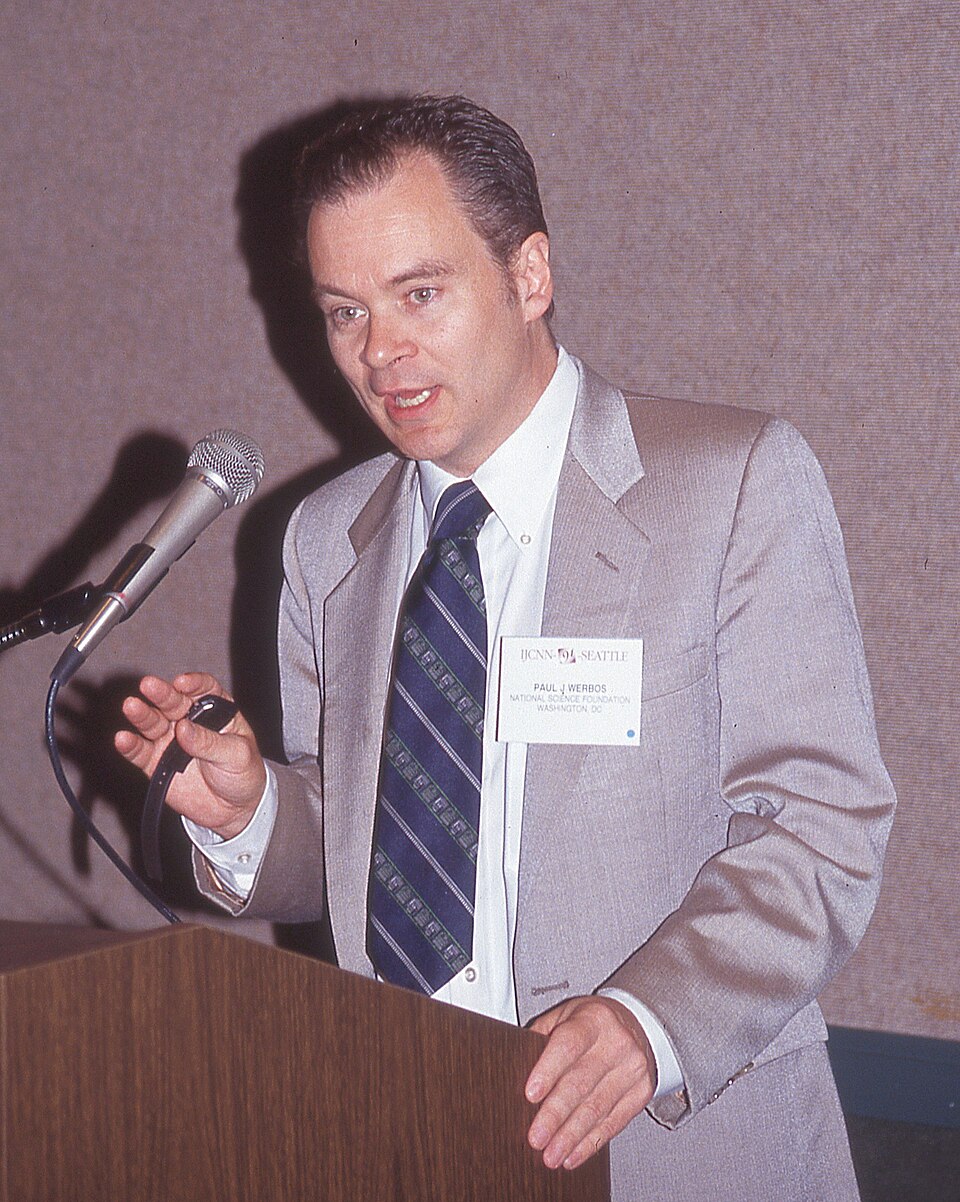
把这个数学工具第一个用到人工神经网络上的,是美国研究者 Paul Werbos。
1974 年,他在哈佛大学的博士论文里明确提出:用「反向传播误差」来训练多层网络。可惜那正是人工智能的冬天,这份开创性的工作几乎没人注意。
思想已经在了,只是还在等一个被世界看见的时机。

1986 年 10 月 9 日,杂志《自然》(Nature)登了一篇论文:「用反向传播学习表征」(Learning representations by back-propagating errors),作者是三个人:Rumelhart、Hinton、Williams。
这篇论文把前人的数学工具和神经网络连在一起,讲得清楚、实验有力,「反向传播」这个名字从此传遍全世界::答案错了,就把误差从最后一层倒着传回去,逐层算出每个权重该改多少。它证明了多层网络能学到有用的内部表征,连单层怎么也学不会的「异或」也能解决——多层网络第一次真正「学」得起来。所以很多人把他们当作反向传播的「集大成者」。

靠什么能一层层倒着算?密钥是数学里的链式法则:一个结果受谁影响、影响多大,可以一层层乘回去。
于是每个权重都知道了「我该改多少」,各自微调一点点。反复几万次之后,网络就真的学会了——这就是今天所有神经网络的学习方式。

可惜好景不长。期待过高、承诺没兑现,投资人撕资、经费被砍,「神经网络」在申请里几乎成了禁区。1987—1993 年,正是第二次「AI 冬天」。
1987 年,辛顿干脆搬到了加拿大,因为那里还有人愿意支持「让机器自己学」。他像一团小火苗,在漫长的冬天里安静地烧着——一烧,就是好几十年。

2006 年,辛顿提出深度信念网络,用一个巧妙的办法把深层网络重新点亮:先让每一层单独学(像一层一层点灯),再合起来整体微调。
这一次,人们终于相信:深层网络不只是想象,是真能训练的。

2012 年,辛顿带着两名学生做出 AlexNet,去参加全球图像识别比赛:把错误率从 26.2% 一口气降到 15.3%,而第二名还在 26% 上下。
从那一年起,「深度学习」成了全世界最热的方向。而让这些深层网络能学会的,正是 1986 年那个算法。
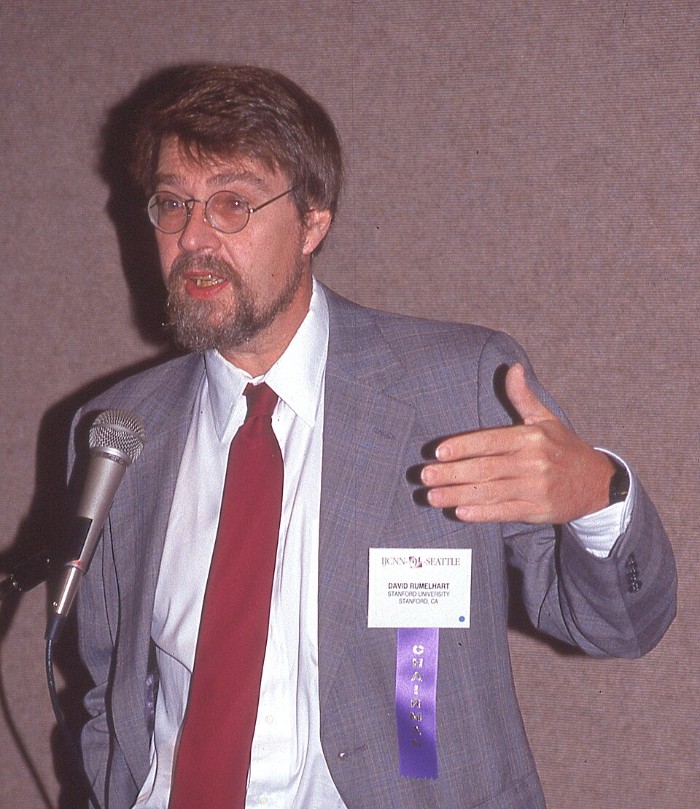
戴维·鲁梅尔哈特(David Rumelhart,1942—2011)是那篇论文的第一作者、当时「平行分布处理(PDP)研究组」的核心人物;辛顿与他并肩几十年,把这条路坚持到了最后;罗纳德·威廉姆斯则把链式法则的推导写得清清楚楚。
但这不是三个人的发明,而是一段跨越数十年的接力:后一棒总是接在前一棒上。
鲁梅尔哈特一生低调,2011 年去世,没能等到荣誉加身的那一天。
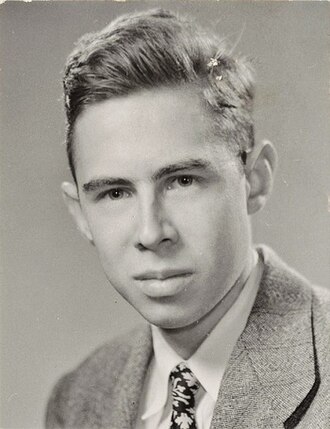
这条线索可以追得更早:1960 年,Henry J. Kelley 就在控制理论里给出了连续版的前身算法;1962 年,Frank Rosenblatt(感知机的发明者)第一次用了「反向传播误差」这个说法。
所以「谁是发明者」一直有争论:当代最著名的批评来自 LSTM 之父 Jürgen Schmidhuber,他认为核心应归功Linnainmaa(1970),1986 年那三位的贡献在于「推广」。
不管怎么争,有一件事是明白的:反向传播是集体智慧的结晶——数学的洞见、引入神经网络的勇气、让它变成标准方法的推广,三步都不能少。
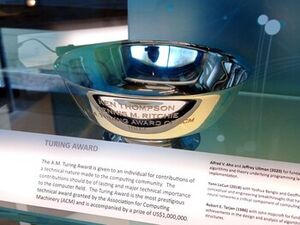
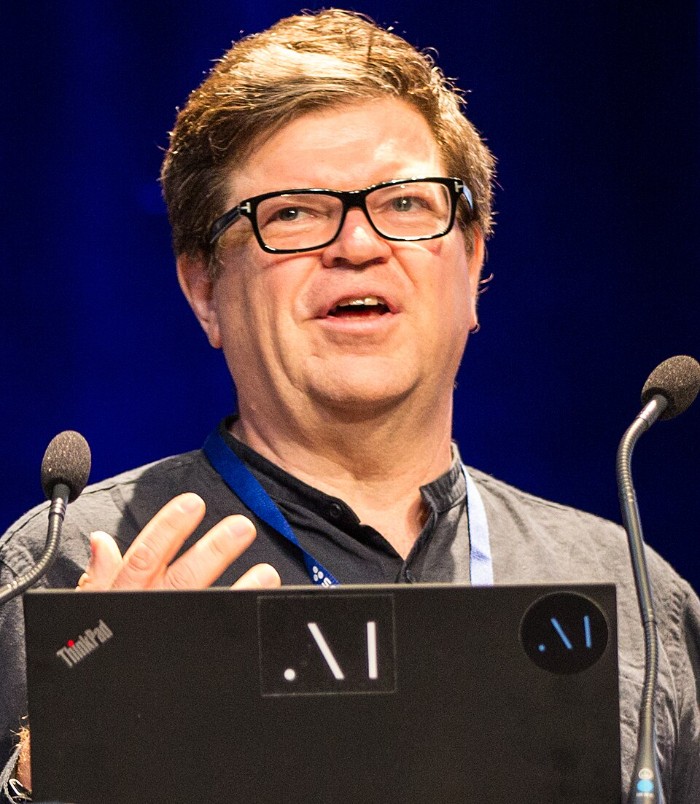
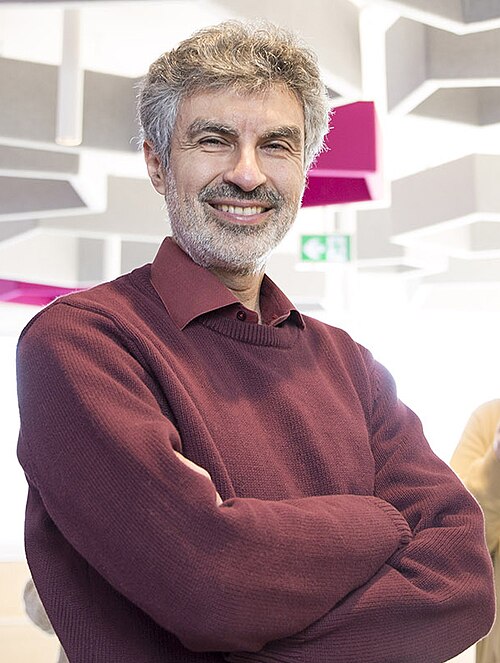
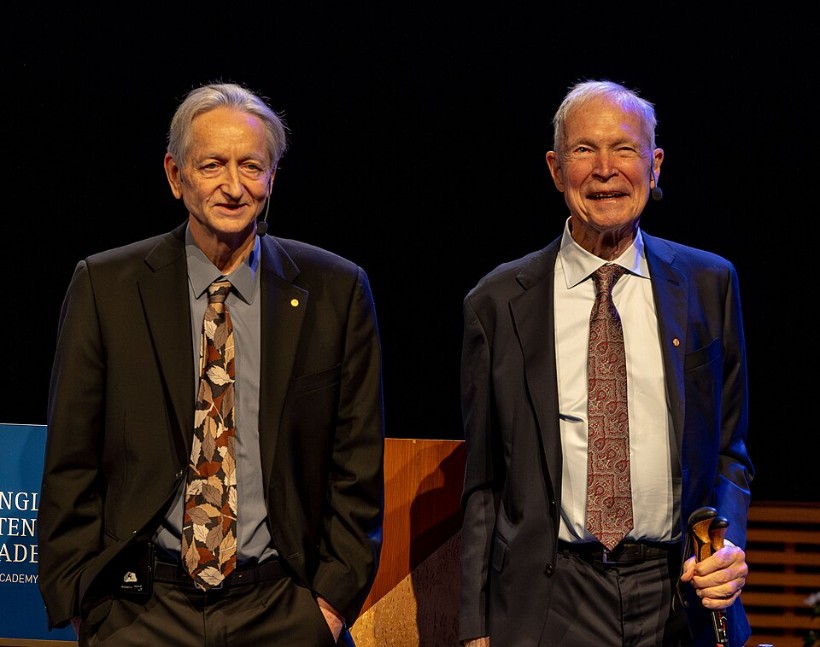
2018 年,计算机界最高奖——图灵奖颁给了深度学习的三位开拓者:Hinton、LeCun、Bengio(鲁梅尔哈特已于 2011 年去世)。
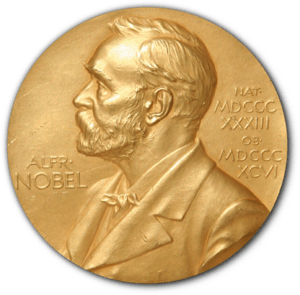
2024 年,辛顿与霍普菲尔德因「为人工神经网络奠基」获得诺贝尔物理学奖。当年被说成「死路」的方向,一口气拿下了两项最高荣誉。

今天你用到的每一个大模型——聊天机器人、文生视频、AI 智能体——训练时都在用同一招:算出误差、倒着传回去、各自改一点点权重。
反向传播就是「让多层网络学会」的那台发动机:1986 年点火,一直烧到今天。
🖼️ 图片:辛顿、鲁梅尔哈特、LeCun、Bengio、诺贝尔四人合照与奖杯奖章照片来自维基共享资源(Wikimedia Commons);其余示意图为本课件自制。