← 返回课程 🛰️ E04 · 第9课 2012 年 · 人工智能简史 🧠 机器学习 · 深度学习深度学习(Deep Learning)机器学习里「网络叠很多层」的那一支:不用人告诉它看什么,它自己从数据里找出一层比一层更抽象的特征。层级:人工智能 ⊃ 机器学习 ⊃ 深度学习本站在这一门里的位置:2012 年谷歌大脑用无监督学习自己长出「猫神经元」,深度学习从此爆发。

🐱 电脑学会了认猫:深度学习爆发

🎯 了解 2012 年谷歌大脑用「没标签」的图做无监督学习、自己长出「猫神经元」——深度学习 = 让机器自己找规律
2012 🐱 第 9 站 / 16 · 2012 年

电脑学会了认猫:深度学习爆发

没人贴标签,它自己看了几百万张图,长出了「猫」细胞
🎯 本课目标:了解 2012 年谷歌大脑用「没标签」的图做无监督学习、自己长出「猫神经元」——深度学习 = 让机器自己找规律

🕰️ 故事时间 · 那时候发生了什么?

2012 年 · 🐱
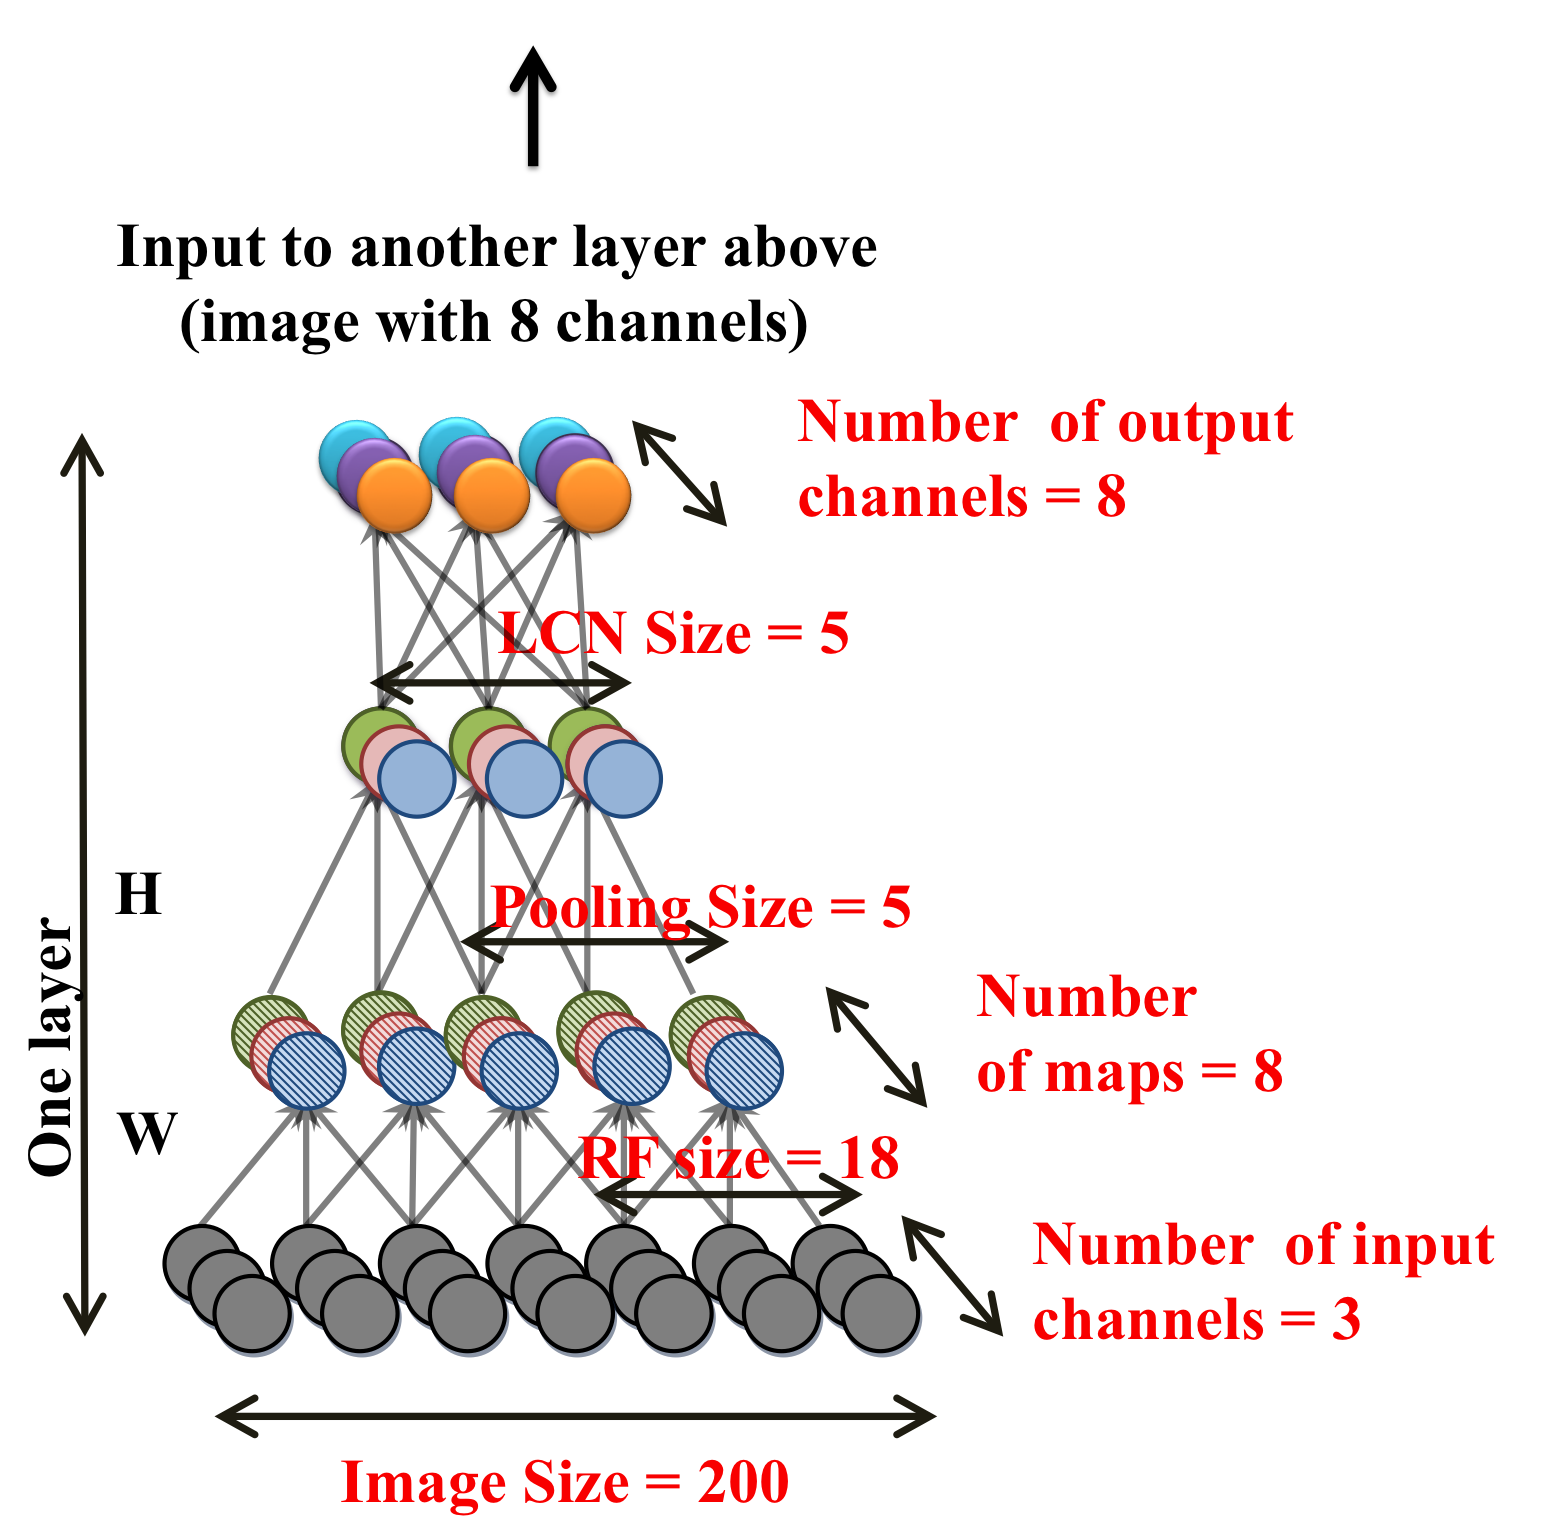
谷歌大脑 2012 年论文里的网络结构原图:一张图从下往上一层层提炼(简单层、池化层、归一化层),再往上输入到更上一层
谷歌大脑 2012 年「认猫」用的网络结构(论文原图):一张图从下往上一层层提炼——简单层 → 池化层 → 归一化层(图中「One layer」这一层);这样的层一共叠 3 次,合起来是 9 层,图片就顺着箭头「往上进入更上一层」。层数越多、叠得越「深」,所以叫深度神经网络

🖼️ 图:谷歌大脑团队 2012 年论文(Quoc V. Le 等,ICML 2012)里的网络结构原图 · 仅作教学使用
1950 年代 — 2000 年代 · 背景
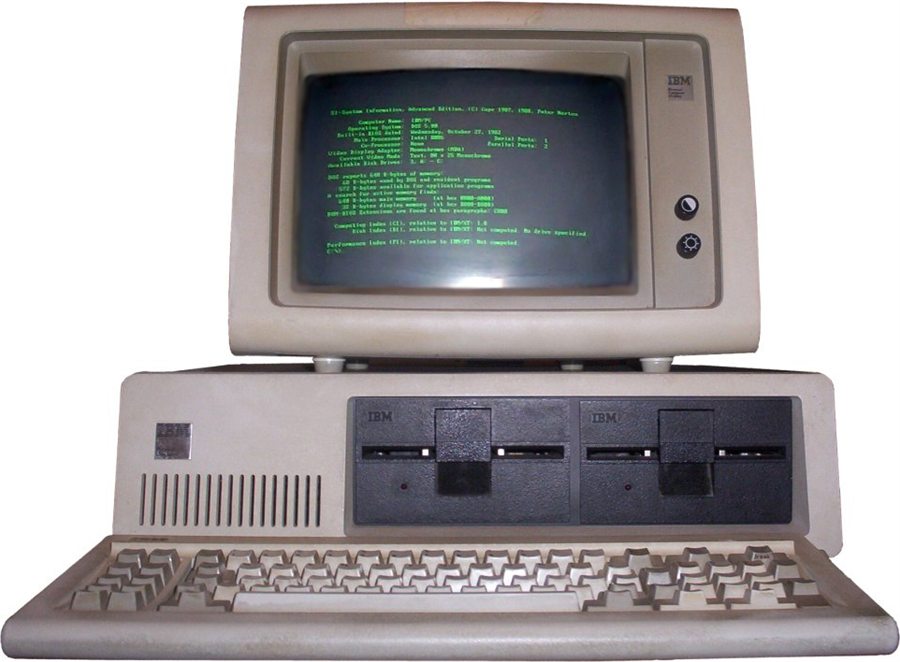
1981 年的 IBM PC:主机、显示器和键盘
那时候的电脑长这样(1981 年的 IBM PC):几乎没见过几张图,也算不动大网络。背景 · 真实照片

「让机器自己学」这个想法,其实一点也不新:1957 年有感知机,1986 年有反向传播(第 3 课、第 6 课都讲过)。2006 年,辛顿又用「深度信念网络」证明:多层网络可以一层一层自己学——老想法重新被点燃。可它一直没能真正「能干」起来——因为它还缺两样东西。

第一,没有数据:那时候的电脑几乎没见过几张图,更不知道「猫」长什么样。第二,没有算力:电脑太慢,稍微大一点的网络就算不动。缺了这两样,神经网络只能一直「沉睡」。
2000 年代 · 条件齐了
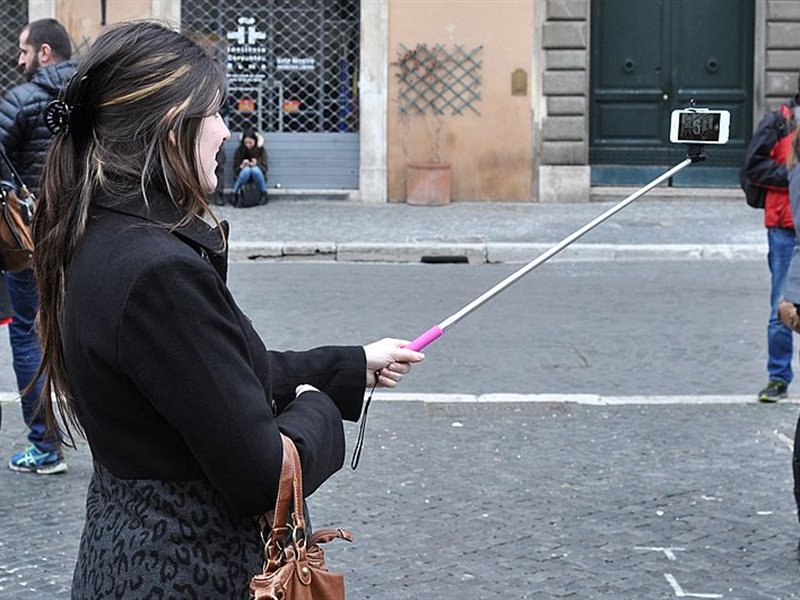
一个人举着自拍杆用手机拍照
① 数据:人人都在用手机拍照、上传。真实照片
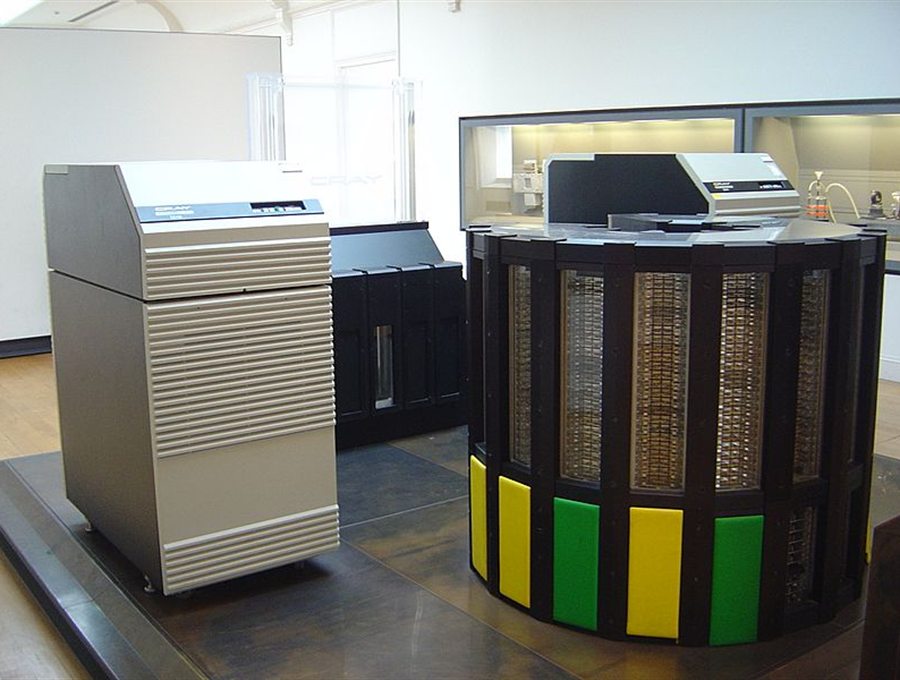
一台巨型超级计算机:圆柱形的主机和成排机柜
② 算力:越来越快的超级计算机。真实照片

到了 2000 年代,情况变了:上网的人越来越多,每天有上亿张照片被传上互联网——数据有了;计算机越来越快,还能用原本为打游戏设计的显卡(GPU)一起算——算力有了。

老想法 + 海量数据 + 超强算力,三样凑齐,就等着有人来点上那把火。
2012 年 6 月 · 实验 · 谷歌大脑
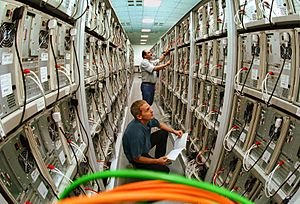
机房里一排排服务器机柜,两位工程师站在过道里
机房实拍:一排排机柜里全是 CPU。真实照片 · CC BY-SA 3.0
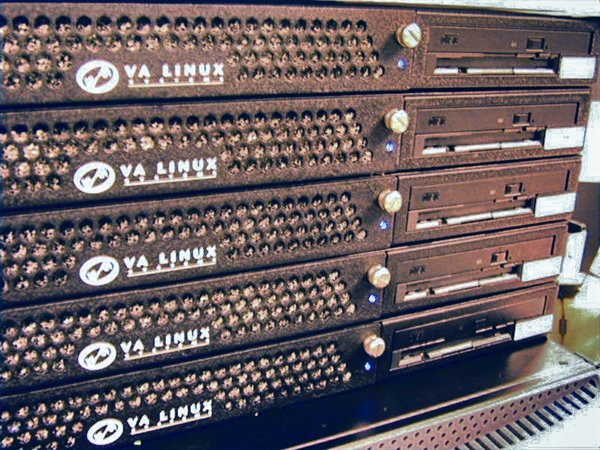
服务器机柜特写:一层一层的机器叠在一起
「一台大电脑」= 一万六千个 CPU 拼起来。真实照片 · CC BY-SA 2.0
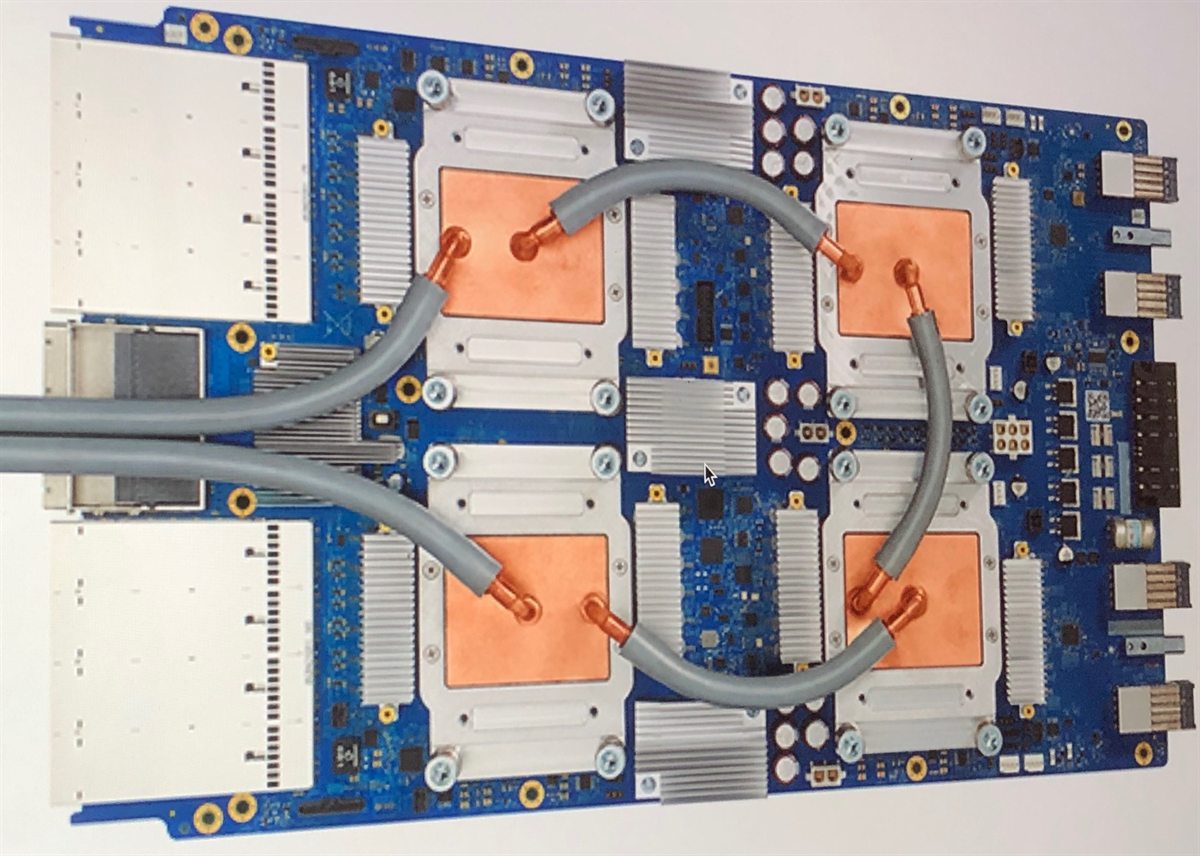
谷歌为深度学习专门造的 TPU 计算板:蓝色电路板上装着四块芯片和铜质散热片
谷歌为深度学习专门造的芯片 TPU(图为 TPU 3.0 计算板)。真实照片 · CC BY-SA 4.0
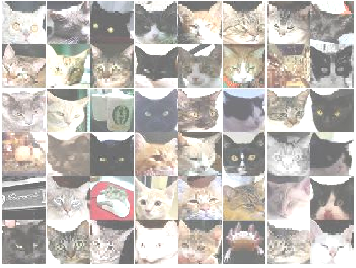
谷歌大脑论文里的实验原图:那颗「猫神经元」最兴奋的 48 张图片,几乎全是猫脸
猫神经元最兴奋的 48 张图,几乎全是猫脸!图:谷歌大脑 2012 年论文 · 实验原图

2012 年 6 月,谷歌的「谷歌大脑」团队(吴恩达、杰夫·迪恩等人)做了一个大胆的实验:把 16,000 个 CPU 拼成一台大电脑,让一个超级大的神经网络自己去看 1,000 万张 YouTube 截图——这些图一张标签都没有,没有人告诉它哪张是猫。

看着看着,奇迹发生了:网络深处慢慢「自己长」出一颗特别的神经元——给它看猫脸,它就特别兴奋;看别的东西,它就安安静静。人们把这一刻称为「猫神经元」:没有人教它,它自己认出了「猫」。
2012 年 10 月 · 发布
一块 NVIDIA GPU 芯片,装在绿色的电路板上
AlexNet 就是靠显卡里的 GPU 练出来的(图为一块 NVIDIA GPU)。发布 · 2012 年 10 月 · 真实照片

同一年 10 月,在著名的 ImageNet 图像识别大赛上,辛顿团队的 AlexNet两块显卡就把「认错率」从往年的 26.2% 一下子降到 15.3%,甩开第二名一大截。

新闻轰动了全世界——人们发现:只要把网络做得更深、喂给它更多数据,机器就能自己找到规律,不需要人一项一项地教。
💡 最终影响
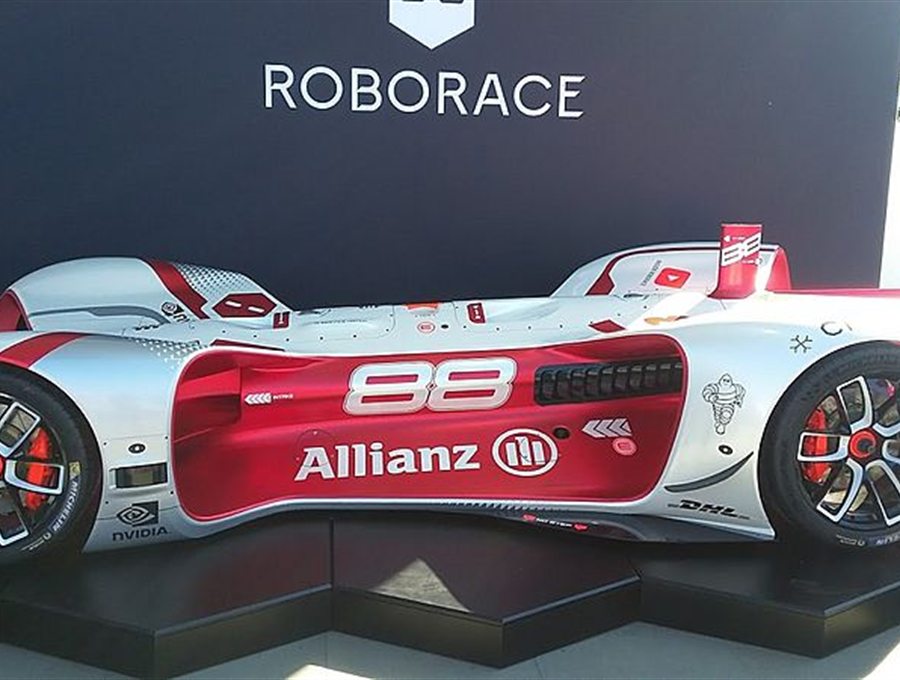
赛道上行驶的无人驾驶赛车
自己开的车 · 真实照片
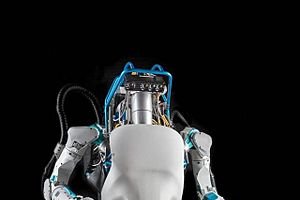
一台人形机器人的上半身
会走会看的机器人 · 真实照片
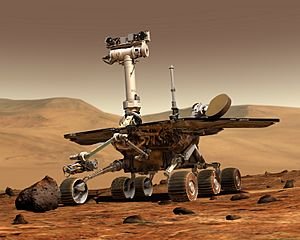
火星上的探测车,自己看路、自己往前走
火星上自己找路的车 · 真实照片

这一年被称为「深度学习」的爆发年:机器开始像小婴儿一样,自己看、自己学,不需要大人一句句教。从这以后,手机能认人脸、音箱能听懂你说话、汽车能自己开、火星上的探测车能自己找路……今天 AI 能做到的许多事,几乎都是从这一刻「觉醒」的。

它们背后都是同一件事:深度学习 = 网络做得更深 + 喂更多数据,让机器自己找规律。

🖼️ 图片:顶部「网络结构图」和「猫神经元实验图」都是谷歌大脑团队 2012 年论文(Quoc V. Le 等,ICML 2012)里的原文插图——他们就是用这个网络看 1000 万张没标签的图、自己长出了「猫神经元」;其余全部为真实照片:IBM PC(1981)、手机拍照、超级计算机、机房与机柜、TPU 计算板、GPU 芯片、无人赛车、人形机器人、火星探测车,取自维基共享资源(经 kids.kiddle.co 镜像)

📖 知识小课堂 · 记住这个魔法!

点击卡片翻开,看看背后的知识~

自己学👆 点我翻开
AI 看几百万张「没标签」的图,没人教就自己长出「猫神经元」
缺的是两样东西👆 点我翻开
老想法一直干不起来:那时既没有数据,也没有算力
📱两样都到齐了👆 点我翻开
2000 年代:上亿张照片上了网,显卡(GPU)还能一起算
💡深度学习👆 点我翻开
不写规则,让机器自己从数据里找规律;用很多层网络的那种最厉害
🔑学习链条👆 点我翻开
先找边线 → 再拼局部 → 最后长出会认「猫脸」的细胞
🐱猫神经元👆 点我翻开
1,000 万张没标签的图,让它自己长出一个一见猫脸就兴奋的神经元
🚀2012 · AlexNet👆 点我翻开
靠两块显卡,把 ImageNet 的认错率从 26.2% 降到 15.3%
🌍全面爆发👆 点我翻开
从这一年起:手机认脸、音箱听懂人话、汽车自己开,都开始了

🖐️ 动手试一试 · 深度学习「认猫」实验室

🧠
深度学习实验室 · 网络很深,规律是它自己找到的 用一个「缩小版」模拟 2012 谷歌大脑:12 层网络、1.5 万张没标签的图(真实那台是 9 层、1000 万张图、16000 个 CPU),深处长出「🐱猫细胞」

🎯 深度学习,就靠这两点

  • 网络要“深”:层数非常多,像千层糕一样一层叠一层。越往里走看得越“整体”:浅层找边线 → 中层拼眼睛耳朵 → 深层拼出整张猫脸。
  • 规律是它自己找到的:没人给图片贴标签,更没人告诉它“对/错”。它只做一件事:把每张没名字的图吞进去再复原。因为 YouTube 上猫特别多、猫脸又都长得差不多,看多了,网络深处自己长出一个一见“猫脸”就兴奋的神经元——“猫细胞”(2012 谷歌大脑新闻里最出名的一幕)。
喂给它的是: 📷 一大堆【没标签】的图(它不知道哪张是猫)
○ 神经元 | 一列=一层,越窄=神经元越少 | 中间最窄那两列 = 浓缩的“代码” | 带彩色光环的 = 它自己长出的探测器 | 左=吃进去的真图 · 右=它脑里复原的样子
👀 它自己看了 0 张【没标签】的图 | 自己找到的规律: L3 探测器 L6 探测器 L9 🐱猫细胞
第 0 / 12 层
💭 想一想:它为什么能“自己长出猫细胞”?——因为层数深(能一层层组合出越来越复杂的东西),又看了超多没标签的图。规律不是人写死的、也不是人贴好标签喂给它的,是它自己从数据里长出来的。这就是 2012 年震撼世界的「深度学习」。

❓ 小测验 · 你学会了吗?

点选答案,答对会变绿、答错会变红(可重试)~

Q1. 深度学习最神奇的地方是什么?

Q2. 2012 年,谷歌大脑的神经网络自己长出了一个对什么特别敏感的细胞?

Q3. 是谁「教」它认识猫的?

Q4. 实验室里那个「缩小版谷歌大脑」,叠了多少层?

Q5. 画布里那一列列排着的圆圈,代表什么?

Q6. 训练的时候,它到底在做什么?

Q7. 为什么越深的层认出来的东西越「整体」?

Q8. 2012 年谷歌大脑真正那台,是用多少个 CPU 拼出来的?

🏁 回顾与完课 · 为自己盖章

我从故事里记住了一个新知识我能把这个故事讲给家人听我完成了一次小任务挑战我想把这一站和下一站连起来想一想

💭 思考一下:机器自己看很多没标签的图,就长出了「猫细胞」。那「学会」到底是什么?人小时候又是怎么学会认东西的?

🏅

人工智能简史 · 完课证明

小小学员 完成了 本站电脑学会了认猫:深度学习爆发

学会:没人贴标签,AI 自己看几百万张图,长出了「猫」细胞

第 9 站
已完课